Laboratorio de series de tiempo: seis algoritmos sobre tres series que no se parecen
Una serie de tiempo rompe el supuesto que sostiene casi toda la estadística clásica: que las observaciones son independientes. En una serie, el valor de hoy se parece al de ayer, y esa dependencia es a la vez el problema y la oportunidad. El problema, porque invalida las fórmulas habituales. La oportunidad, porque es exactamente lo que permite pronosticar.
Este laboratorio recorre ese terreno con tres series elegidas para que no se comporten igual. Un laboratorio donde todos los métodos ganan no enseña a elegir.
| Serie | Qué es | Por qué está |
|---|---|---|
co2 |
CO2 en Mauna Loa, mensual, 1958 a 2001 | Tendencia clarísima y estacionalidad anual fuerte. El caso de manual. |
nile |
Caudal anual del Nilo, 1871 a 1970 | Cien observaciones y un quiebre estructural. El caso donde un modelo global falla. |
sunspots |
Actividad solar anual, 1700 a 2008 | Ciclo de once años que no es entero. El caso donde la estacionalidad clásica no sirve. |
Las tres vienen empaquetadas con statsmodels, así que el laboratorio corre sin
internet. El código está en
proyectos/lab-series-tiempo.
cd proyectos/lab-series-tiempo
python lab.py                    # las seis secciones
python lab.py --seccion 4        # solo la comparación
python lab.py --json resultados.json
1. Estacionariedad, y el caso incómodo
Casi todo el aparato clásico supone que la serie es estacionaria: media, varianza y autocovarianza que no dependen del momento. Casi ninguna serie real lo es en nivel, y por eso el primer paso es diferenciar.
adf = sm.tsa.adfuller(serie.to_numpy(), autolag="AIC")
# H0: hay raíz unitaria, o sea NO es estacionaria.
# p alto = no se puede rechazar = hay que diferenciar.
prueba de Dickey-Fuller aumentada (H0: raíz unitaria, no estacionaria)
  co2          ADF=  2.233  p=0.9989  NO estacionaria
  co2 d1       ADF= -4.752  p=0.0001  estacionaria
  nile         ADF= -4.049  p=0.0012  estacionaria
  nile d1      ADF= -4.680  p=0.0001  estacionaria
  sunspots     ADF= -2.838  p=0.0531  NO estacionaria
  sunspots d1  ADF=-14.862  p=0.0000  estacionaria
Nótese la dirección de la hipótesis nula, que se confunde todo el tiempo: H0
es que la serie NO es estacionaria. Un p alto no permite rechazarla, así que
hay que diferenciar. Es al revés de lo que la intuición sugiere.
co2 es inequívoca: p ≈ 1.00 en nivel, y una diferencia la arregla. nile ya
es estacionaria, lo que tiene sentido para un caudal que oscila alrededor de una
media.
sunspots queda en p = 0.0531, o sea justo del lado de no rechazar por dos
milésimas. Ese es el caso incómodo y el más instructivo, porque la decisión no
se toma con el p solo. Sobrediferenciar una serie que ya era estacionaria
introduce autocorrelación negativa artificial en el rezago 1 y ensancha los
intervalos del pronóstico. Ante la duda conviene mirar la ACF y probar las dos
opciones, no obedecer a un umbral.
Antes de eso, una nota de honestidad que el laboratorio imprime:
co2: 5 meses sin lectura fueron interpolados antes de modelar
El dataset trae huecos reales. Se interpolan, y se deja constancia de cuántos eran. Un hueco tapado en silencio es un dato inventado, y a la vuelta de tres meses nadie recuerda cuáles eran medidos y cuáles no.
2. Descomponer: qué parte es tendencia y qué parte estacionalidad
clasica = sm.tsa.seasonal_decompose(s, model="additive", period=12)
stl = sm.tsa.STL(s, period=12, robust=True).fit()
clásica        residuo: desv= 0.283  máx |r|= 1.106
STL robusta    residuo: desv= 0.255  máx |r|= 1.157

fuerza de la tendencia      1.000
fuerza de la estacionalidad 0.984
La fuerza de cada componente se define como
y su análoga para la estacionalidad, con el residuo, la tendencia y el componente estacional. Da entre 0, ausente, y 1, dominante. Con CO2 las dos están cerca de 1, que es lo que uno esperaría de la serie más ordenada de la climatología.
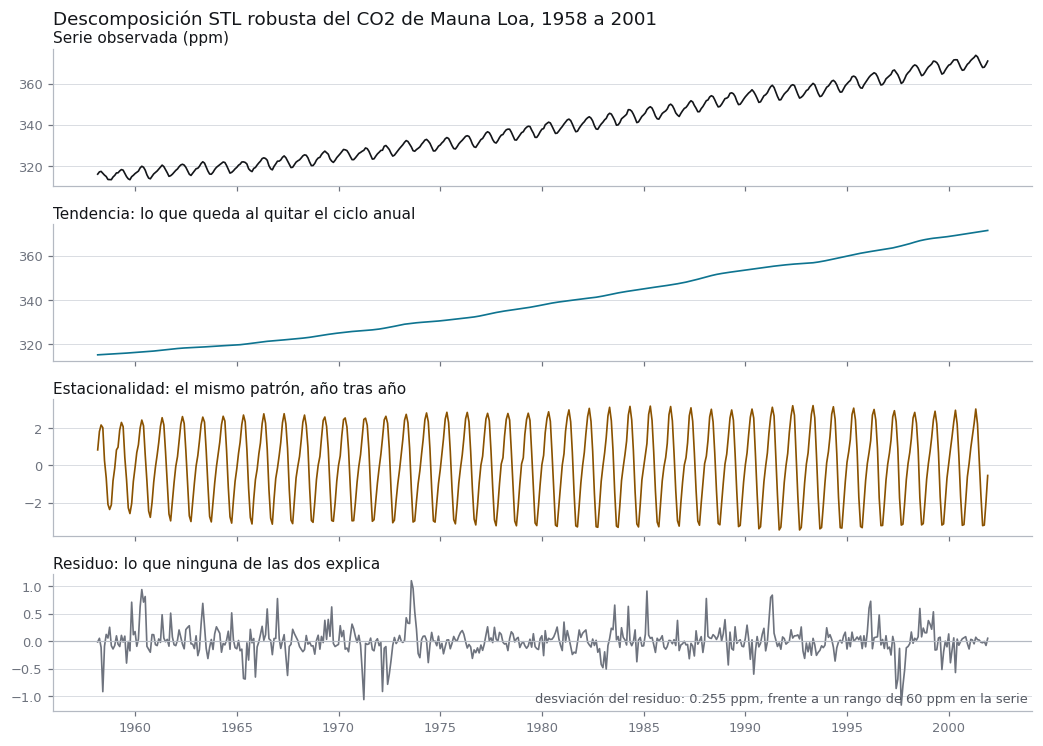
El patrón estacional medio, en ppm sobre la tendencia:
 1:-0.03   2:+0.61   3:+1.42   4:+2.46   5:+2.86   6:+2.34
 7:+0.74   8:-1.34   9:-3.04  10:-3.15  11:-2.04  12:-0.87
Máximo en mayo, mínimo en septiembre y octubre. La explicación estándar es el ciclo de la vegetación del hemisferio norte, que absorbe carbono durante el verano boreal; la cito como interpretación, no como algo que este laboratorio demuestre. Una amplitud de 6.01 ppm entre el pico de mayo y el valle de octubre.
STL contra la descomposición clásica. La clásica supone que el patrón
estacional es idéntico todos los años; STL permite que evolucione despacio y,
con robust=True, no deja que un año raro deforme el resto. Con 43 años de
datos esa diferencia deja de ser teórica, y se ve en la desviación del residuo:
0.255 contra 0.283.
3. Autocorrelación: lo que dice qué modelo puede funcionar
acf = sm.tsa.acf(s.to_numpy(), nlags=26, fft=True)
pacf = sm.tsa.pacf(s.to_numpy(), nlags=26)
banda = 1.96 / np.sqrt(len(s))      # significancia aproximada
La ACF mide la correlación de la serie consigo misma a distintos rezagos. La PACF mide lo mismo descontando los rezagos intermedios. La diferencia es la que orienta la elección entre un modelo AR y uno MA: una PACF que se corta de golpe en el rezago p sugiere AR(p); una ACF que se corta en q sugiere MA(q).
co2 (diferenciada): n=525, banda ±0.086
  rezagos con ACF significativa: [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12] …
  primer pico de PACF fuera de banda: 1

sunspots: n=309, banda ±0.112
  ACF máxima entre rezagos 8 y 14: rezago 10
En sunspots la ACF marca el ciclo solar alrededor del rezago 10. Que no es
estacionalidad en el sentido de SARIMA conviene demostrarlo en vez de
afirmarlo, así que el laboratorio detecta los picos de la serie y mide los
intervalos entre ellos:
ciclo solar medido sobre los 28 picos del dataset:
  intervalo entre picos: mínimo 7, máximo 17 años
  media 10.9, mediana 11
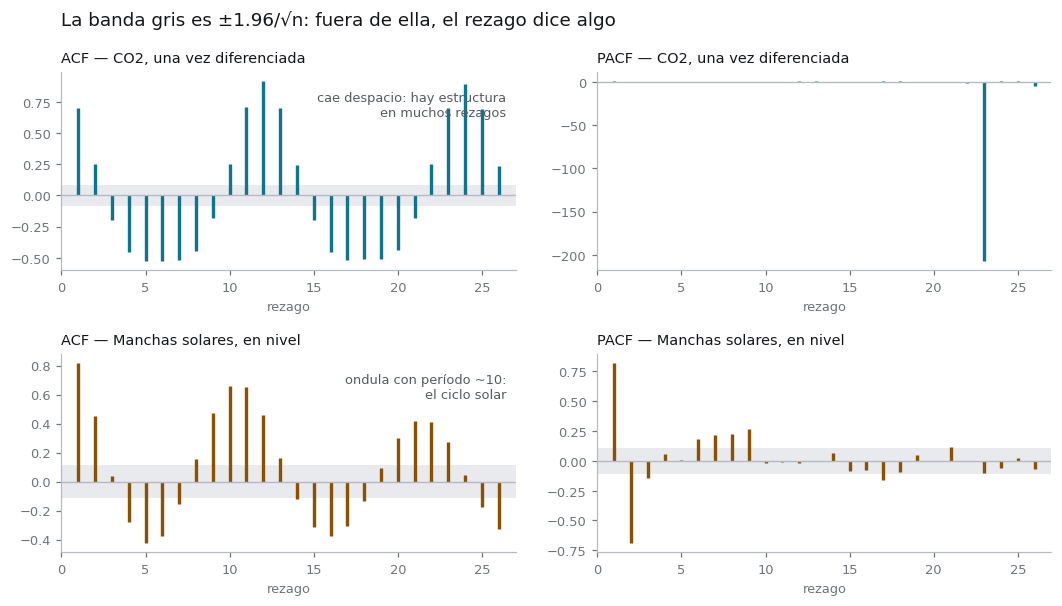
La media da 10.9 años, que es el número que uno esperaba. Pero el período
varía entre 7 y 17 años, o sea un rango de una década entera. SARIMA exige un
m constante y entero, y acá no lo hay: por eso un SARIMA con m = 11 ajusta
peor de lo que la intuición sugiere, y por eso esta serie está en el
laboratorio.
Vale señalar cómo llegué a ese párrafo, porque es el método más que el dato. Había escrito de memoria que el ciclo "varía entre nueve y catorce años". Al medirlo sobre el propio dataset, el rango real resultó bastante más ancho. La cifra que uno recuerda suele ser el rango típico, no el observado.
4. Seis algoritmos, la misma partición, las mismas métricas
Sobre CO2, con los últimos 24 meses reservados para prueba.
# 1. Ingenuo estacional: el valor de hace doce meses. La referencia.
modelos["Ingenuo estacional"] = np.array(
    [tr.iloc[-12 + (i % 12)] for i in range(h)])

# 3. Holt-Winters: tendencia y estacionalidad, sin diagnóstico previo
hw = sm.tsa.ExponentialSmoothing(
    tr, trend="add", seasonal="add", seasonal_periods=12,
    initialization_method="estimated").fit()

# 4. SARIMA: lo que la ACF de la sección anterior sugiere
sarima = sm.tsa.SARIMAX(tr, order=(1, 1, 1), seasonal_order=(1, 1, 1, 12),
                        enforce_stationarity=False,
                        enforce_invertibility=False).fit(disp=False)

# 6. Theta: método simple con muy buen desempeño en competencias, poco usado
from statsmodels.tsa.forecasting.theta import ThetaModel
theta = ThetaModel(tr, period=12).fit()
Antes de la tabla, la métrica. Uso MASE, error absoluto escalado:
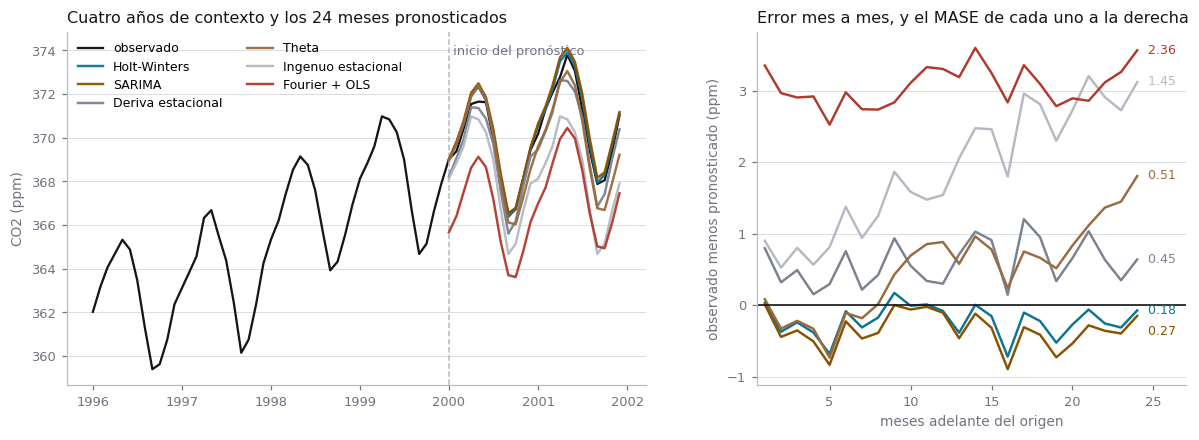
El denominador es el error de la predicción ingenua estacional dentro del entrenamiento. Un MASE de 1 significa "igual de bueno que repetir el valor de hace m períodos"; menor que 1, mejor. Y como es adimensional, el 0.18 de una serie de CO2 y el 0.18 de una serie de demanda eléctrica significan lo mismo, cosa que el MAE en unidades originales nunca permite.
                      MAE   RMSE   MASE  mejora_vs_ingenuo_%
modelo
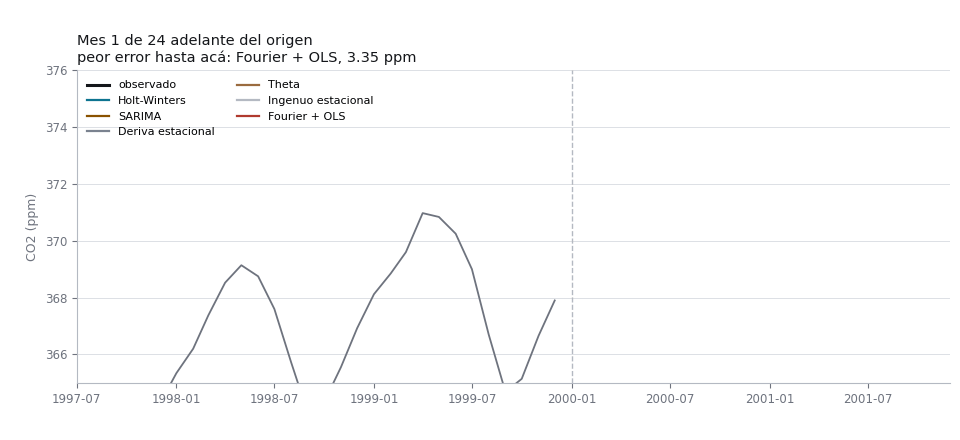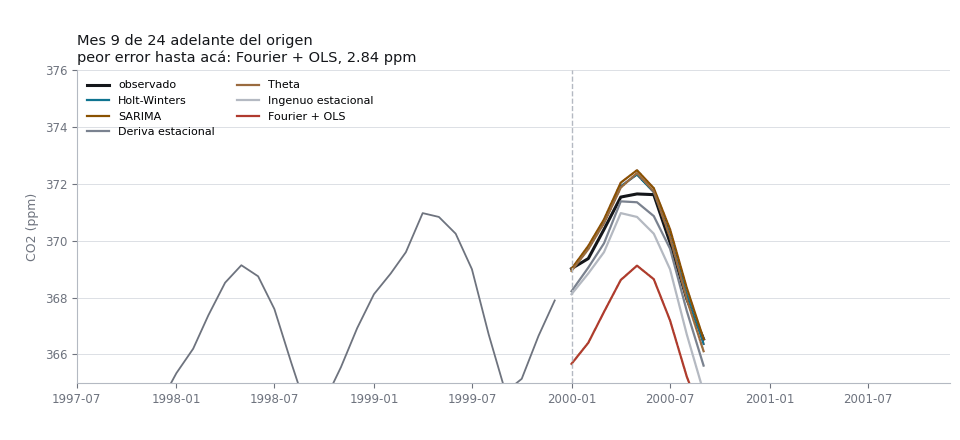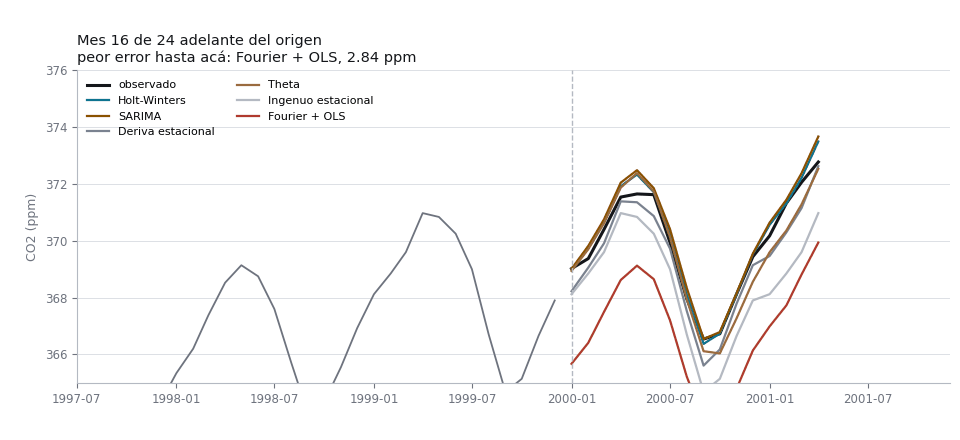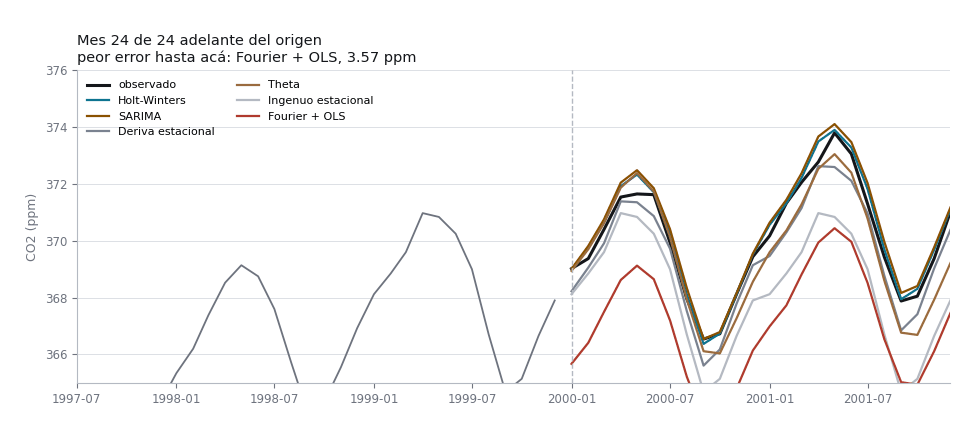
Holt-Winters        0.236  0.307  0.182               87.479
SARIMA              0.351  0.425  0.270               81.377
Deriva estacional   0.590  0.663  0.454               68.662
Theta               0.663  0.800  0.510               64.783
Ingenuo estacional  1.882  2.066  1.450                0.000
Fourier + OLS       3.062  3.074  2.358              -62.693
Tres lecturas.
Holt-Winters gana, con un MASE de 0.182. Conviene leer ese número con cuidado, porque admite dos comparaciones distintas: es 5.5 veces mejor que la predicción ingenua calculada dentro del entrenamiento, que es lo que el denominador del MASE mide, y 8.0 veces mejor que la fila del ingenuo estacional de esta tabla, que se evaluó sobre el período de prueba. Las dos lecturas son correctas y no son la misma. No hizo falta ningún diagnóstico previo para ajustarlo, lo cual es parte de su atractivo. Una serie con tendencia limpia y estacionalidad estable es exactamente su caso.
Fourier + OLS pierde contra el ingenuo, con MASE de 2.36. Y es instructivo por qué: la regresión con tendencia lineal más armónicos supone que la tendencia es recta, y la de CO2 no lo es.
Vale comprobarlo en vez de afirmarlo. Ajustando una parábola a la tendencia que extrae STL, el coeficiente cuadrático sale positivo, , o sea convexa, y admitir esa curvatura reduce la suma de cuadrados en 87 % frente a la recta. Al extrapolar 24 meses, recta y parábola se separan en 4.20 ppm promedio, que es del mismo orden que el MAE de 3.06 ppm que el modelo produjo. El diagnóstico cierra: el error del modelo de Fourier es, casi entero, error de curvatura de la tendencia.
Los modelos de la parte de arriba de la tabla modelan la tendencia localmente, con un nivel y una pendiente que se actualizan, así que no arrastran ese sesgo. Ahí está la diferencia de fondo entre ajustar una forma global y seguir la serie.
El ingenuo estacional no es un espantapájaros. Con MASE de 1.45 no gana, pero cualquier modelo que quede por debajo de él, como el de Fourier, es un modelo que hay que descartar. Es el control que dice si el trabajo sirvió, y por eso está en la tabla.
5. Un modelo no está terminado hasta que sus residuos son ruido
r = pd.Series(ajuste.resid).iloc[13:]      # se descarta el arranque
lb = sm.stats.acorr_ljungbox(r, lags=[12, 24], return_df=True)
SARIMA(1,1,1)(1,1,1,12) sobre co2
  media del residuo +0.0625  (debería ser ~0)
  desv. estándar    1.0251

Ljung-Box (H0: los residuos son ruido blanco)
    lb_stat  lb_pvalue
12   5.5730     0.9361
24   7.5132     0.9995

  veredicto: compatibles con ruido blanco
Ljung-Box prueba si un conjunto de autocorrelaciones de los residuos es distinguible de cero. Es la prueba que separa un modelo terminado de uno que todavía tiene señal en la basura.
Si rechaza, quedó estructura sin modelar y el pronóstico puede mejorar sin datos nuevos, solo especificando mejor. Si no rechaza, como acá, el modelo extrajo lo que había: lo que queda es ruido, y para mejorar hay que conseguir información de afuera.
Un detalle de implementación que importa: se descartan las primeras 13 observaciones del residuo. Un SARIMA con diferenciación estacional necesita llenar su estado inicial, y esos primeros residuos son artefactos del arranque, no errores del modelo. Incluirlos ensucia la prueba.
6. El quiebre estructural, y el resultado que contradice al titular
# Chow casero: se prueba cada año como posible quiebre y se busca
# el que más reduce la suma de cuadrados.
for corte in range(15, len(y) - 15):
    a, b = y[:corte], y[corte:]
    sce = ((a - a.mean()) ** 2).sum() + ((b - b.mean()) ** 2).sum()
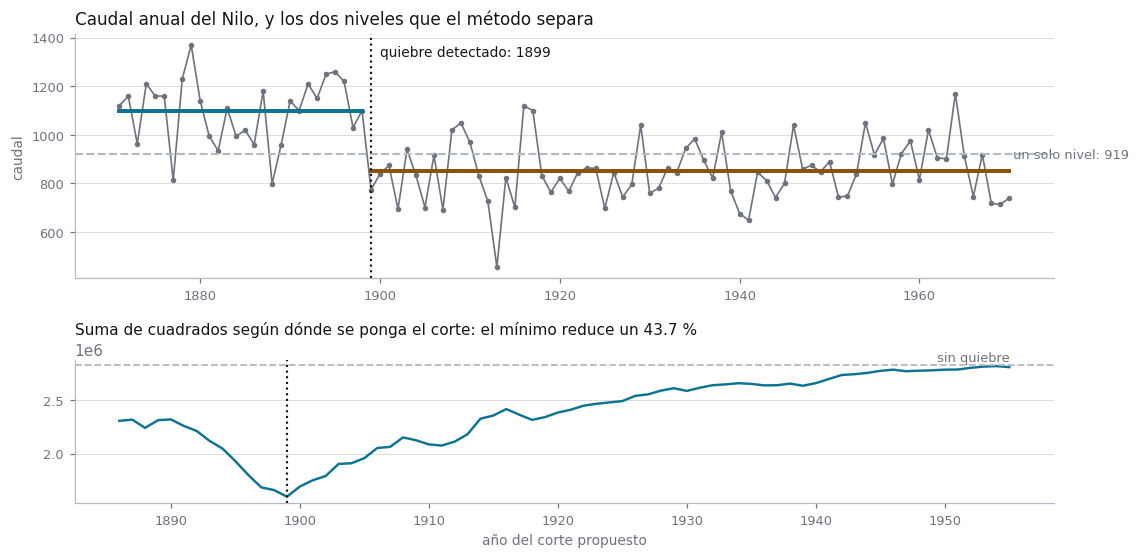
quiebre más probable: 1899
  media antes    1097.8  (n=28)
  media después   850.0  (n=72)
  SCE con un solo nivel        2835157
  SCE con dos niveles          1597457  (43.7 % menos)
El método encuentra 1899 sin que nadie le diga nada del mundo real. La presa baja de Asuán se terminó en 1902, y el dato la ve. El caudal medio cae de 1098 a 850, y admitir dos niveles en vez de uno explica el 43.7 % de la suma de cuadrados.
Hasta acá, el titular se escribe solo: hay un quiebre, hay que tirar los datos viejos. Ahora la parte que no salió como esperaba.
 ventana   entrena con todo   solo post-quiebre  gana
       5              159.9               113.9  post
      10              118.0               121.8  todo
      15              102.7               110.5  todo
      20              108.0               107.0  post
      25              101.7               100.4  post
      30              118.6                93.7  post
Entrenar solo con el régimen vigente gana en 4 de 6 ventanas, no en las seis. Y las diferencias son chicas frente a una serie con desviación estándar de 169.
Escribí primero la versión con una sola ventana de prueba, h = 10, y la conclusión que salió fue la contraria: con esa ventana gana entrenar con todo. Quedarse ahí habría significado publicar "más datos empeoraron el pronóstico" o su opuesto según qué número hubiera elegido, y las dos afirmaciones habrían tenido un respaldo aparente.
El resultado honesto es más útil que el titular. El quiebre es real y grande, pero de ahí no se sigue automáticamente que descartar el pasado mejore el pronóstico, porque descartar también reduce la muestra, y con menos datos la media estimada tiene más varianza. Hay un intercambio entre sesgo y varianza, y una sola ventana de prueba no lo resuelve.
Es la misma lección que el origen móvil: evaluar en un solo corte mide el corte, no el método.
Cómo encaro una serie nueva
El orden que sigo, y que es el orden de las secciones de arriba:
- Graficarla. Antes de cualquier prueba. La mitad de los quiebres, atípicos y cambios de régimen se ven a simple vista.
- Contar los huecos y decidir qué hacer, dejando registro.
- Probar estacionariedad, con ADF y sin obedecer ciegamente al umbral.
- Descomponer con STL para ver cuánto pesan tendencia y estacionalidad.
- Mirar ACF y PACF para saber qué familia de modelos tiene sentido.
- Ajustar la línea base ingenua primero. Siempre. Es el único número que dice si lo demás sirvió.
- Comparar con MASE, no con MAE, para poder trasladar la conclusión a otra serie.
- Diagnosticar residuos con Ljung-Box. Si rechaza, hay margen sin datos nuevos.
- Buscar quiebres, y evaluar en varias ventanas antes de concluir.
Fuentes
Este artículo es un laboratorio. Cada cifra que cita es la salida real de correr
lab.py, y resultados.json guarda los valores en forma estructurada.
- Código completo:
proyectos/lab-series-tiempo.salida.txtes la corrida íntegra que este artículo cita. - Datos, los tres empaquetados con statsmodels y por lo tanto reproducibles
sin descarga:
statsmodels.datasets.co2(concentración de CO2 en Mauna Loa, semanal, agregada acá a mensual),statsmodels.datasets.nile(caudal anual del Nilo en Asuán, 1871 a 1970, 100 observaciones) ystatsmodels.datasets.sunspots(actividad solar anual, 1700 a 2008). La procedencia y las unidades de cada uno están en el atributoNOTEdel dataset, que es lo que leí para describirlos. - Tres afirmaciones que NO verifiqué y que van marcadas como interpretación,
para que no se confundan con lo que el laboratorio demuestra:
- La presa baja de Asuán se terminó en 1902. Contexto histórico ampliamente documentado, pero no lo contrasté con una fuente primaria. Lo que sí está verificado es lo que el método encuentra sin ayuda: un quiebre en 1899 que reduce la suma de cuadrados en 43.7 %. La atribución histórica es mía.
- El ciclo estacional del CO2 se explica por la vegetación del hemisferio norte. Es la explicación estándar en climatología y no la verifiqué acá. Lo que el laboratorio muestra es el patrón, con su pico en mayo y su valle en octubre; la causa es interpretación.
- El método Theta tuvo un desempeño destacado en las competencias de pronóstico M. Lo menciono como contexto de por qué vale la pena probarlo, no como resultado verificado en esta sesión. Lo que sí está medido acá es su MASE de 0.510 sobre esta serie, que lo deja cuarto de seis.
- Versiones: Python 3.13.9, numpy 2.3.5, pandas 2.3.3, statsmodels 0.14.5.
ThetaModelvive enstatsmodels.tsa.forecasting.thetay no está expuesto ensm.tsa, cosa que descubrí porque el primer intento falló. - Métodos y estadísticos usados: Dickey-Fuller aumentado, descomposición STL, ACF y PACF, suavizamiento exponencial de Holt-Winters, SARIMA, regresión con armónicos de Fourier, método Theta, MASE y prueba de Ljung-Box. No consulté bibliografía para escribir este artículo: las implementaciones son las de statsmodels y lo que se afirma sobre su comportamiento se verificó ejecutándolas. La definición de fuerza de tendencia y estacionalidad de la sección 2, y el uso de MASE como métrica escalada, provienen de la literatura estándar de pronóstico, en particular del texto de Hyndman y Athanasopoulos Forecasting: Principles and Practice, disponible en otexts.com/fpp3; no lo abrí en esta sesión, así que va como referencia para el lector y no como respaldo verificado de una cita textual.
Este es el tercero de tres laboratorios de fundamentos. El primero cubre pandas y las bibliotecas de gráficos; el segundo, la estadística inferencial que este da por sabida.