Fundamentos de estadística para un analista, con los datos a la vista
Un analista de mercados produce números todos los días: un promedio, una variación, una correlación entre dos series. La pregunta que decide si ese trabajo sirve o no es siempre la misma, y no es cómo se calcula el número. Es cuándo el número significa algo.
Este artículo es un laboratorio alrededor de esa pregunta. Los datos son los
mismos del artículo anterior, macrodata de statsmodels: 203 trimestres de
macroeconomía de Estados Unidos entre 1959Q1 y 2009Q3, empaquetados con la
biblioteca, así que corre sin internet y da el mismo resultado en cualquier
máquina. Todas las cifras que se citan son la salida real de correrlo.
El código está en
proyectos/lab-estadistica.
cd proyectos/lab-estadistica
python lab.py              # las siete secciones
python lab.py --seccion 6  # solo una
El artículo anterior terminó con un resultado incómodo: una recta de regresión entre desempleo e inflación con la pendiente al revés de lo que predice la teoría. La sexta sección de este artículo lo desarma, y el camino hasta ahí es lo que un analista necesita tener firme.
1. La media miente cuando la distribución no es simétrica
from scipy import stats

s = d["infl"]
print(f"media {s.mean():.2f}   mediana {s.median():.2f}   desv {s.std():.2f}")
print(f"MAD robusta {stats.median_abs_deviation(s, scale='normal'):.2f}")
print(f"asimetría {stats.skew(s):+.2f}   curtosis {stats.kurtosis(s):+.2f}")
print(f"media podada al 10 %: {stats.trim_mean(s, 0.1):.2f}")
inflación:
  media     3.96   mediana     3.24   desv. est.    3.25
  MAD robusta   1.96   asimetría  +0.74   curtosis  +2.23
  media podada al 10 %: 3.65
La media supera a la mediana en 0.72 puntos. Eso no es ruido: es lo que pasa cuando la distribución tiene cola derecha larga, que es lo que la asimetría de +0.74 está diciendo. Presentar 3.96 % como "la inflación típica" del período sobreestima lo que ocurrió en un trimestre normal, porque unos pocos trimestres de los años setenta, con inflación de dos dígitos, arrastran la media.
Las tres medidas robustas de arriba merecen estar en el repertorio:
- Mediana: el valor que parte la muestra en dos. Un solo valor extremo no la mueve.
- MAD, desviación absoluta mediana: la dispersión robusta. Con
scale="normal"queda en las mismas unidades que una desviación estándar, y acá da 1.96 contra 3.25 de la clásica. Esa brecha es la firma de las colas. - Media podada: descarta el 10 % de cada extremo antes de promediar. Da 3.65, entre la media y la mediana.
La desviación estándar eleva los desvíos al cuadrado, así que un atípico la domina. La MAD no. Cuando las dos difieren mucho, como acá, la clásica está describiendo las colas más que el centro.
2. ¿Es normal? Casi nunca
w, p = stats.shapiro(s)                    # potente para n < 5000
jb, pjb = stats.jarque_bera(s)[:2]         # mira asimetría y curtosis
inflación  Shapiro W=0.9109 p=1.06e-09   Jarque-Bera=  60.66 p=6.71e-14   NO normal
desempleo  Shapiro W=0.9574 p=8.93e-06   Jarque-Bera=  22.71 p=1.17e-05   NO normal
Ninguna de las dos series es normal, y eso es lo habitual con datos reales. La pregunta que sigue no es si son normales, sino si eso importa para lo que voy a hacer. La prueba t y el intervalo de confianza clásico suponen normalidad de la media muestral, no de los datos. Y ahí entra el teorema que todo el mundo cita mal.
3. El teorema central del límite, medido en vez de citado
El teorema dice que la distribución de la media muestral tiende a la normal aunque la población no lo sea. Lo que no dice, y todo el mundo asume, es a partir de qué tamaño de muestra.
poblacion = d["infl"].to_numpy()
sk0 = abs(stats.skew(poblacion))

for n in (2, 5, 10, 30, 50, 100):
    medias = RNG.choice(poblacion, size=(4000, n), replace=True).mean(axis=1)
    sk = stats.skew(medias)
    ks = stats.kstest(medias, "norm",
                      args=(medias.mean(), medias.std(ddof=1))).statistic
    print(f"{n:>4d}  {sk:>+8.3f}  {ks:>8.4f}  {abs(sk)/sk0:>6.0%}")
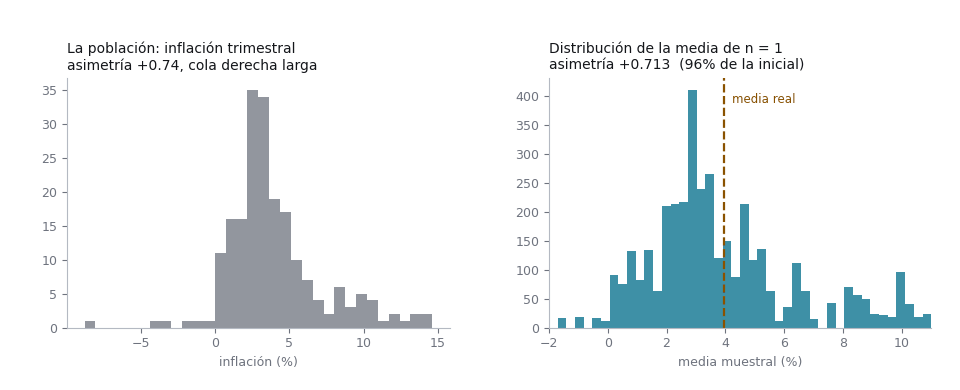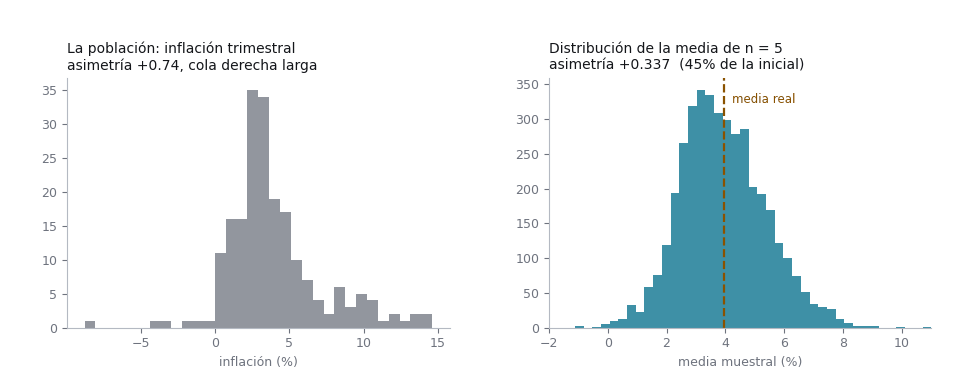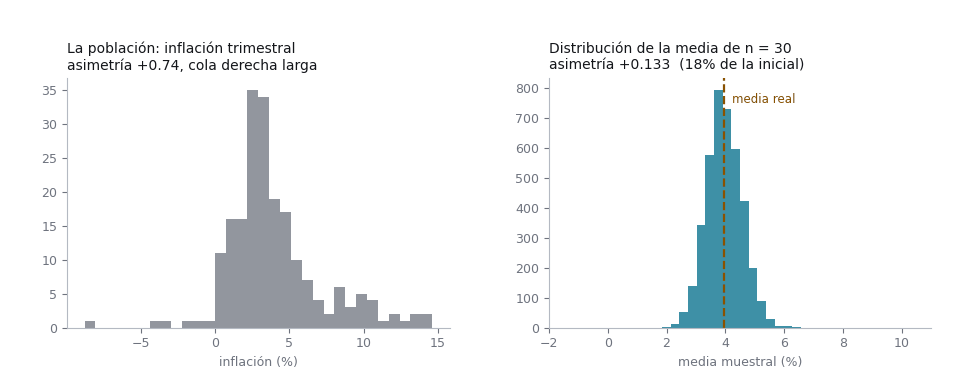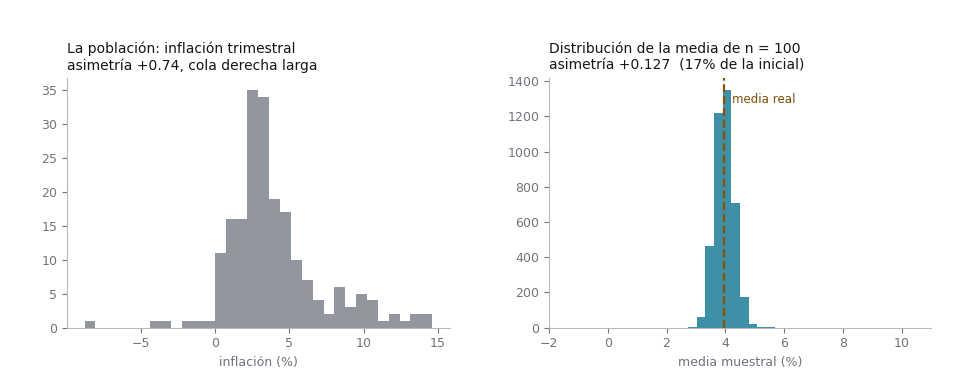
población: n=203  asimetría=+0.74

   n   asimetría residual   distancia KS   % de la asimetría inicial
   2               +0.483         0.0909                        65%
   5               +0.386         0.0399                        52%
  10               +0.199         0.0205                        27%
  30               +0.166         0.0169                        22%
  50               +0.155         0.0167                        21%
 100               +0.111         0.0182                        15%
Una decisión de diseño de esta tabla vale explicarla, porque es el mismo error
que el artículo advierte más adelante. Reporto magnitudes, no veredictos. La
tentación era correr una prueba de normalidad sobre cada fila y escribir "sí" o
"no", pero un test sobre 4000 remuestreos rechaza cualquier desviación por
diminuta que sea, así que su p oscila sin decir nada útil. La asimetría
residual y la distancia de Kolmogorov-Smirnov sí decrecen de forma ordenada, y
es eso lo que el teorema promete.
La regla de "n = 30" es una convención, no un teorema. Con esta población, a n = 30 todavía queda un 22 % de la asimetría original. Cuánto es tolerable depende de para qué se use: para un intervalo de confianza aproximado, alcanza; para estimar un percentil extremo, no.
4. Un intervalo de confianza no dice lo que casi todos creen
media, ee = s.mean(), stats.sem(s)
lo_t, hi_t = stats.t.interval(0.95, len(s) - 1, loc=media, scale=ee)

# Bootstrap: no supone normalidad, solo que la muestra representa
# a la población.
res = stats.bootstrap((s,), np.mean, n_resamples=10000, random_state=7,
                      confidence_level=0.95, method="BCa")
lo_b, hi_b = res.confidence_interval
desempleo en los 2000: n=39  media=5.415  error estándar=0.203
  IC 95 % por t          [5.004, 5.826]  ancho 0.822
  IC 95 % por bootstrap  [5.090, 5.910]  ancho 0.821
Los dos anchos coinciden casi exactamente, y eso es información: significa que la suposición de normalidad era inofensiva en este caso. Cuando las dos vías divergen, hay que creerle al bootstrap, porque supone menos.
Ahora lo que el intervalo significa. Formalmente:
y la probabilidad está sobre el intervalo, que es aleatorio porque depende de la muestra, no sobre , que es un número fijo y desconocido.
Traducido: si repitiéramos el muestreo muchas veces y construyéramos un intervalo cada vez, el 95 % de esos intervalos contendría la media verdadera. Lo que no significa es que haya 95 % de probabilidad de que la media esté en este intervalo particular. Ya está o no está; lo que no sabemos es cuál de los dos casos nos tocó.
La distinción parece pedante hasta que alguien la usa para decidir. "Hay 95 % de probabilidad de que el costo esté entre X e Y" es una afirmación bayesiana que este intervalo no autoriza.
La única forma en que esa definición deja de sonar a trampa verbal es verla correr. El experimento que la define es este: conocer la media verdadera de la población, sacar una muestra, construir su intervalo, y contar cuántos la atrapan.
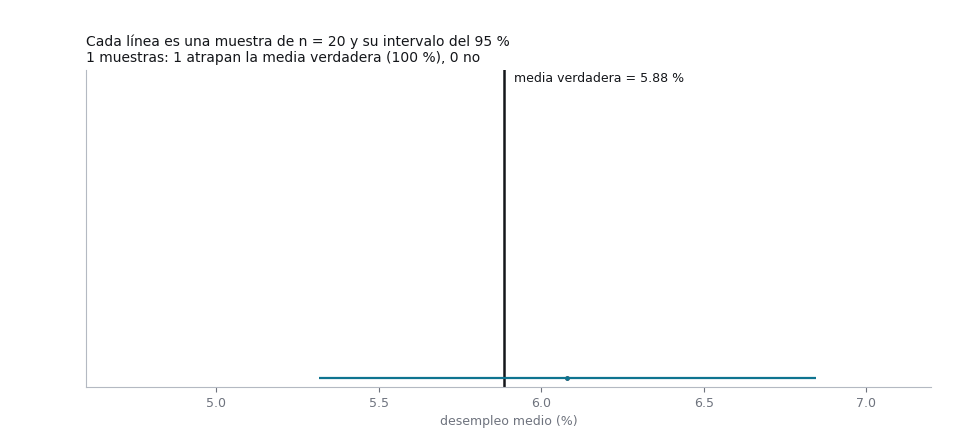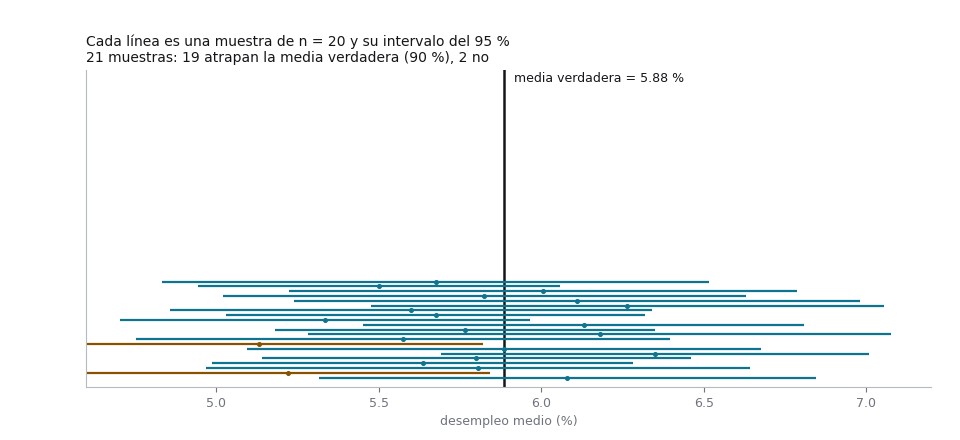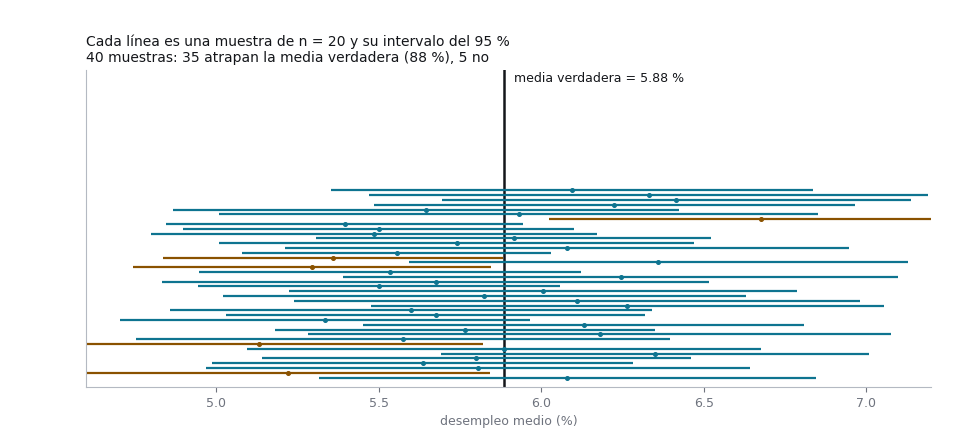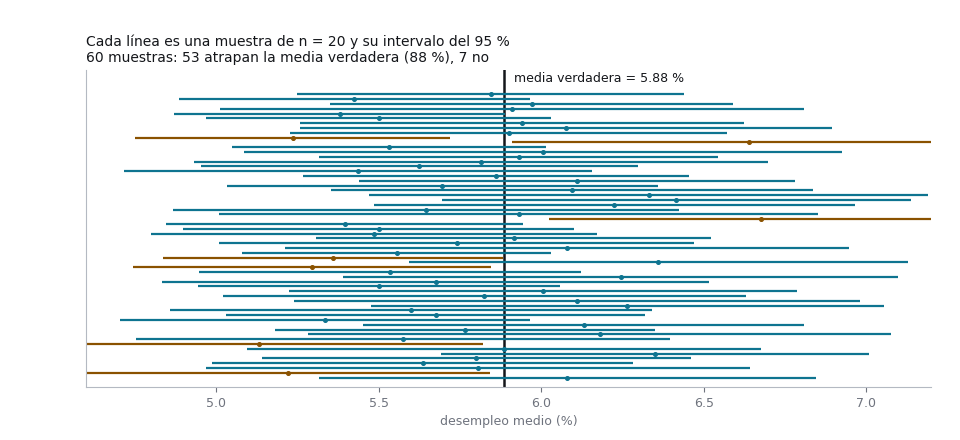
Y acá el laboratorio se contradice a sí mismo de una manera instructiva. Al terminar la animación, 53 de esas 60 muestras atrapan la media: 88.3 %, no 95 %. Con eso a la vista sería tentador escribir que el intervalo t subcubre porque la población es asimétrica, que es una afirmación plausible y que encaja con la sección 2.
Sería falso, y la manera de descubrirlo es repetir el experimento más veces:
cobertura estimada según cuántas veces se repita el experimento:
      60 repeticiones → 95.0 % ± 5.5
     200 repeticiones → 98.0 % ± 1.9
    1000 repeticiones → 93.9 % ± 1.5
    5000 repeticiones → 94.6 % ± 0.6
   20000 repeticiones → 94.5 % ± 0.3
La cobertura real es 94.5 %, o sea nominal. El 88.3 % de la animación es ruido de muestreo: estimar una proporción cercana a 0.95 con 60 repeticiones tiene un margen de ±5.5 puntos, así que cualquier valor entre 89 y 100 es compatible con un procedimiento perfecto.
Nótese que es la misma aritmética de la raíz de n de dos párrafos más abajo, aplicada a sí misma: para medir una cobertura del 95 % con un margen de un punto hacen falta unas dos mil repeticiones. Sesenta líneas alcanzan para mostrar la idea, y no para medirla.
Y una aritmética que arruina presupuestos:
Cuánta muestra hace falta para partir el ancho a la mitad:
  n×1  → ancho relativo 1.000
  n×2  → ancho relativo 0.707
  n×4  → ancho relativo 0.500
  n×8  → ancho relativo 0.354
El ancho cae con , no con . Para partir la incertidumbre a la mitad hay que cuadruplicar la muestra. Cuando alguien pide "el doble de precisión", eso es lo que está pidiendo, y conviene decirlo antes de aceptar.
5. Significancia contra magnitud
t, p = stats.ttest_ind(a, b, equal_var=False)   # Welch, no supone varianzas iguales
u, pu = stats.mannwhitneyu(a, b)                # no supone normalidad
# d de Cohen: cuántas desviaciones estándar separan a los grupos
cohen = (a.mean() - b.mean()) / s_pool
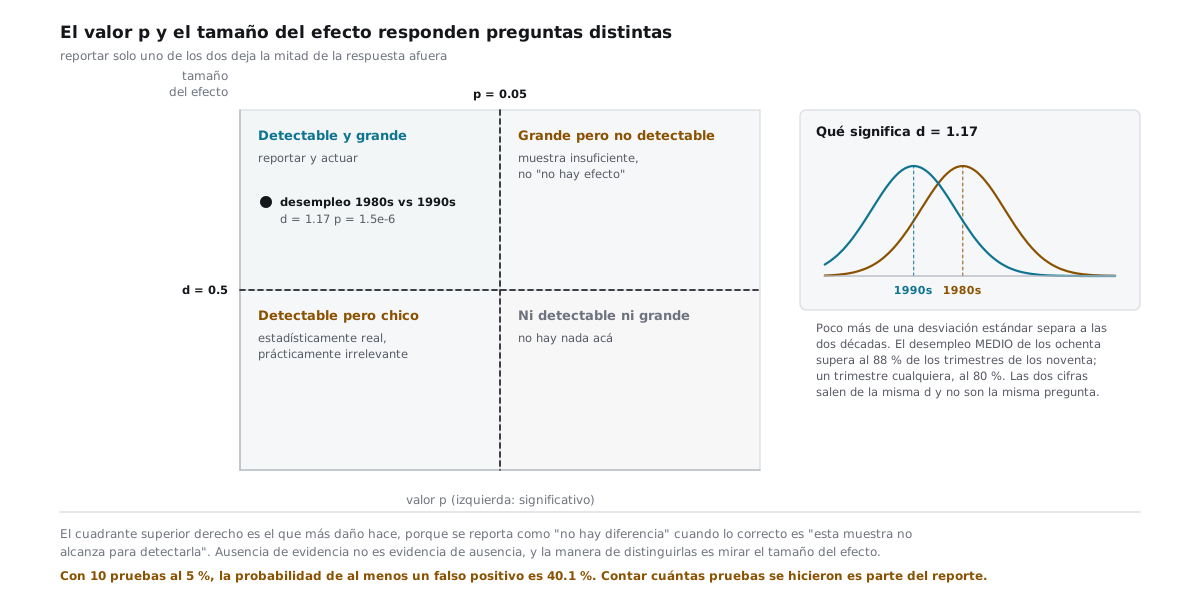
desempleo 1980s (n=40, media 7.28) contra 1990s (n=40, media 5.77)
  t de Welch     t=+5.249  p=1.54e-06
  Mann-Whitney   U=1264   p=8.21e-06
  d de Cohen     +1.174  (grande)
Tres cosas para llevarse.
Usar Welch por defecto. equal_var=False no supone varianzas iguales, y esa
suposición casi nunca se verifica antes de invocarla. El costo de Welch cuando
las varianzas sí son iguales es despreciable; el costo de la t clásica cuando no
lo son es un p equivocado.
El p y el tamaño del efecto responden preguntas distintas. El p dice si
la diferencia es distinguible del ruido. La d de Cohen dice si importa. Con
muestras grandes, un p diminuto puede acompañar a una diferencia irrelevante,
y reportar solo el p oculta esa distinción. Acá la d es de 1.17, o sea grande:
la diferencia entre décadas no solo es detectable, es sustantiva.
La tercera es la que muerde sola:
comparando las 5 décadas de a pares: 10 pruebas
  significativas a 0.05 sin corregir:        8
  con Bonferroni (0.05/10 = 0.0050):         7
  probabilidad de al menos un falso positivo sin corregir: 40.1%
Con diez pruebas al 5 %, la probabilidad de al menos un falso positivo es . No hace falta hacer nada raro para caer en esto: basta con explorar. Un analista que prueba una docena de relaciones y reporta la que salió significativa está reportando, casi con seguridad, ruido.
Bonferroni, dividir el umbral entre el número de pruebas, es la corrección más conservadora y la más simple. Existen mejores, pero la que hay que tener es el hábito de contar cuántas pruebas se hicieron incluyendo las que no se reportaron.
6. La correlación que existe y desaparece
Acá está el resultado que ordena todo el artículo.
La curva de Phillips dice que el desempleo y la inflación se mueven en direcciones opuestas. Con los 203 trimestres juntos:
agregando los 203 trimestres:
  Pearson  r=+0.065  p=0.3567   no significativa
  Spearman ρ=+0.104  p=0.1409
Correlación prácticamente nula, y del signo equivocado. Es exactamente la recta ascendente de la figura de seaborn del artículo anterior. Ahora, la misma correlación dentro de cada década:
    década    n        r         p
      1960   40   -0.744    0.0000  ←
      1970   40   -0.183    0.2581
      1980   40   -0.113    0.4890
      1990   40   +0.152    0.3485
      2000   39   -0.204    0.2124
En los sesenta la correlación es −0.744, fuerte y con p < 0.0001. Al mezclar las décadas, se evapora.
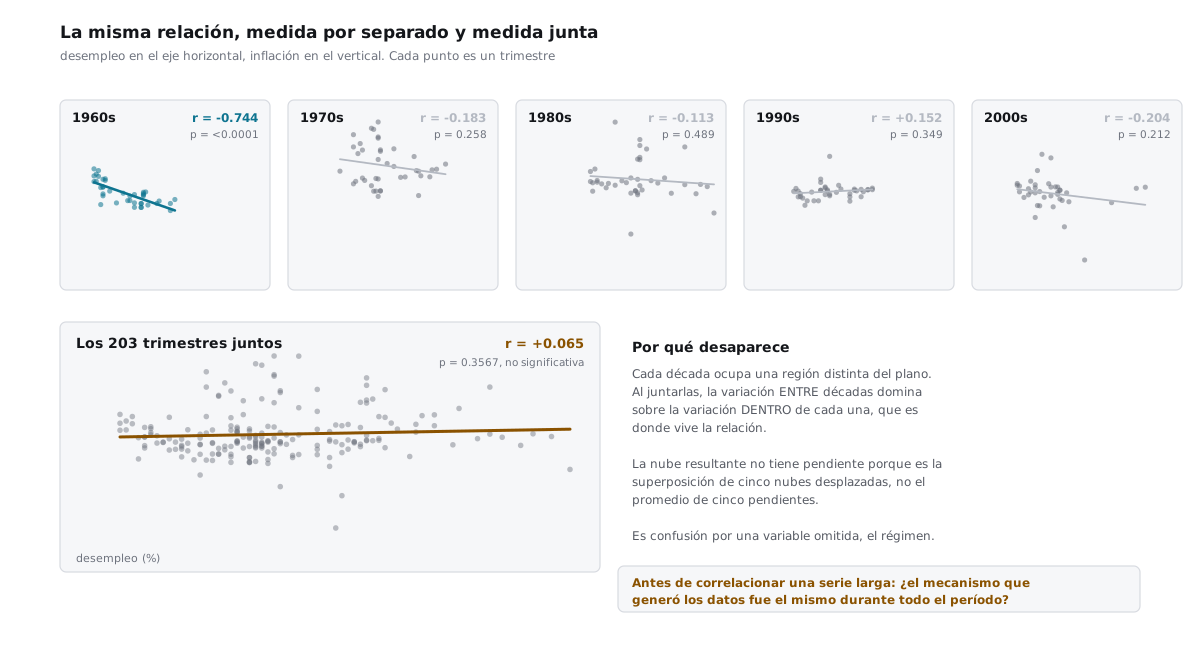
Esto no es una curiosidad estadística: es el modo de falla más caro del análisis de datos aplicado. Agregar períodos con regímenes distintos no promedia la relación, la borra. Cada década tiene su propio nivel de desempleo y de inflación, y al juntarlas la variación entre décadas domina sobre la variación dentro de cada una, que es donde vive la relación.
Es un caso de confusión por una variable omitida, el régimen, y es primo del fenómeno que se conoce como paradoja de Simpson, donde una relación puede incluso invertir el signo al agregar grupos.
La consecuencia práctica, para cualquier rubro: antes de calcular una correlación sobre una serie larga, hay que preguntarse si el mecanismo que genera los datos fue el mismo durante todo el período. En un mercado eléctrico, mezclar años con parques de generación distintos, o con marcos regulatorios distintos, produce exactamente este artefacto. Y la respuesta no es "usar más datos": es segmentar por régimen, o modelar el régimen explícitamente.
7. Regresión: leer la salida completa, no solo el R²
x = d.loc[d["decada"] == 1960]
modelo = sm.OLS(x["infl"], sm.add_constant(x[["unemp"]])).fit()
inflación ~ desempleo, solo 1960s (n=40)
  pendiente   -1.3235  IC 95 % [-1.7139, -0.9331]
  p           3.77e-08
  R²          0.553   R² ajustado 0.542
Dentro de los sesenta, cada punto de desempleo adicional se asocia con 1.32 puntos menos de inflación, con un intervalo que no cruza el cero por márgenes amplios. Esa es la curva de Phillips que la teoría describe.
Lo que casi nadie verifica es si los supuestos que hacen válido ese intervalo se cumplen:
dw = sm.stats.durbin_watson(modelo.resid)
bp = sm.stats.diagnostic.het_breuschpagan(modelo.resid, modelo.model.exog)
diagnóstico de residuos:
  Durbin-Watson 1.905  (sin autocorrelación evidente)
  Breusch-Pagan p=0.1318  (varianza estable)

con errores estándar HAC (Newey-West, 4 rezagos):
  coeficiente -1.3235 (idéntico: HAC no toca la estimación)
  p pasa de 3.77e-08 a 8.16e-06
Durbin-Watson mide autocorrelación de los residuos. Cerca de 2 significa que
no hay; por debajo de 1.5, que un residuo positivo tiende a seguir a otro
positivo. Cuando eso pasa, la pendiente sigue siendo insesgada pero su error
estándar queda subestimado: el intervalo sale más angosto de lo que debería y
el p más chico. Con series de tiempo es la norma, no la excepción.
Breusch-Pagan prueba si la varianza del residuo depende de los regresores. Si depende, los errores estándar clásicos tampoco valen.
Acá los dos diagnósticos salen limpios, y por eso los errores robustos HAC casi no cambian nada. Ese es justamente el uso del diagnóstico: no es que HAC sobre, es que confirma por otra vía que la inferencia clásica era válida. Corro los errores robustos siempre, incluso cuando el diagnóstico dice que no hacen falta, porque el caso en que sí hacían falta y pasó inadvertido es mucho más caro que los dos segundos que cuesta calcularlos.
Y sobre el R²: 0.553 significa que el modelo explica el 55 % de la varianza dentro de esta muestra. No dice nada sobre si la relación se sostiene fuera de ella. La sección anterior mostró que esta misma relación se evapora en las décadas siguientes, y ningún R² alto habría avisado de eso. El R² mide ajuste, no validez.
El resumen, en una página
- Mirar la distribución antes que el promedio. Media contra mediana, desviación estándar contra MAD. Si difieren mucho, la media no describe el centro.
- Reportar magnitud junto con significancia. Un
psin tamaño del efecto es media respuesta. - Contar cuántas pruebas se hicieron, incluidas las que no se reportaron.
- Un intervalo de confianza es una afirmación sobre el procedimiento, no sobre el parámetro. Y su ancho cae con la raíz de n.
- Antes de correlacionar una serie larga, preguntar si el régimen fue el mismo. Es el error que más caro sale y el más difícil de ver.
- Verificar los supuestos de la regresión, no solo mirar el R².
Fuentes
Este artículo es un laboratorio. Cada cifra que cita es la salida real de correr
lab.py, y no hay ninguna afirmación numérica que no provenga de esa corrida.
- Código completo:
proyectos/lab-estadistica.salida.txtes la corrida que este artículo cita, íntegra. - Datos:
statsmodels.datasets.macrodata, empaquetado con la biblioteca. 203 observaciones trimestrales, 1959Q1 a 2009Q3, de cuentas nacionales de Estados Unidos. La descripción de las variables está ensm.datasets.macrodata.NOTE. - Versiones: Python 3.13.9, numpy 2.3.5, pandas 2.3.3, scipy 1.16.3,
statsmodels 0.14.5. Las pruebas de
scipy.statsy los diagnósticos destatsmodelscorresponden a esas versiones. - Sobre las pruebas y estadísticos usados: Shapiro-Wilk, Jarque-Bera, Kolmogorov-Smirnov, t de Welch, Mann-Whitney U, bootstrap BCa, d de Cohen, corrección de Bonferroni, Durbin-Watson, Breusch-Pagan y errores estándar HAC de Newey-West. No consulté fuentes bibliográficas para escribir este artículo: la implementación y las convenciones son las de scipy.stats y statsmodels, y lo que el artículo afirma sobre su comportamiento se verificó ejecutándolas. Quien necesite el desarrollo formal detrás de cada una debe ir a un texto de estadística, no a este artículo.
- Un límite que conviene declarar: la interpretación frecuentista del intervalo de confianza que se explica en la sección 4 es la estándar, y la contrasto con la lectura bayesiana solo para señalar que son afirmaciones distintas. Este artículo no desarrolla el enfoque bayesiano ni pretende compararlos.
El artículo siguiente lleva estos fundamentos a series de tiempo, donde la independencia entre observaciones, que casi todo lo de acá supone, deja de valer.