Análisis de datos con Python: pandas y las cuatro bibliotecas de gráficos
Todo el análisis que hago después, en este cuaderno, descansa sobre las mismas veinte funciones de pandas y sobre saber cuál de las cuatro bibliotecas de gráficos usar. Este artículo es ese piso, escrito como laboratorio: cada bloque de código corre, y lo que se cita como resultado es la salida real de correrlo.
Los datos son macrodata de statsmodels, 203 trimestres de macroeconomía de
Estados Unidos entre 1959Q1 y 2009Q3. Vienen empaquetados con la biblioteca, así
que el laboratorio corre sin internet y da el mismo resultado en cualquier
máquina. Esa propiedad importa más de lo que parece: un tutorial que depende de
una descarga es un tutorial que deja de funcionar.
El código completo está en
proyectos/lab-pandas.
cd proyectos/lab-pandas
python lab.py              # las ocho secciones
python lab.py --seccion 5  # solo una
python graficas.py         # las cuatro bibliotecas
Lo primero es el índice
La mayoría de los problemas que la gente tiene con series temporales en pandas vienen de no haberle dicho a pandas que la tabla es temporal.
import pandas as pd
import statsmodels.api as sm

d = sm.datasets.macrodata.load_pandas().data
# from_fields en vez del constructor: desde pandas 2.2, construir un
# PeriodIndex pasándole year= y quarter= al constructor está deprecado.
idx = pd.PeriodIndex.from_fields(
    year=d["year"].astype(int), quarter=d["quarter"].astype(int), freq="Q"
)
d = d.drop(columns=["year", "quarter"]).set_index(idx)
d.index.name = "trimestre"
Mientras year y quarter sean dos columnas numéricas, pandas no sabe que
esto es una serie: no se puede remuestrear, ni pedir una ventana de dos años,
ni cortar por fecha. Con un PeriodIndex toda la maquinaria temporal queda
disponible de golpe.
PeriodIndex y no DatetimeIndex porque un trimestre es un intervalo, no
un instante. Si se guarda 2008Q1 como el timestamp del 1 de enero, hay que
recordar para siempre si ese timestamp representa el inicio, el final o el
centro del trimestre. Period no tiene esa ambigüedad. El precio es que
matplotlib y plotly no lo entienden, así que a la hora de graficar hay que
convertir con .to_timestamp().
Inspección: lo que casi nadie hace completo
print(f"forma: {d.shape[0]} filas × {d.shape[1]} columnas")
print(f"memoria: {d.memory_usage(deep=True).sum() / 1024:.1f} KiB")
print(f"nulos totales: {int(d.isna().sum().sum())}")

# describe() por defecto oculta los percentiles que más importan para
# detectar colas. Pedirlos explícitamente cuesta lo mismo.
d[["realgdp", "unemp", "infl", "tbilrate"]].describe(
    percentiles=[0.01, 0.25, 0.5, 0.75, 0.99]
).round(2)
Salida real:
forma: 203 filas × 12 columnas
memoria: 20.6 KiB
nulos totales: 0

        realgdp   unemp    infl  tbilrate
count    203.00  203.00  203.00    203.00
mean    7221.17    5.88    3.96      5.31
std     3214.96    1.46    3.25      2.80
min     2710.35    3.40   -8.79      0.12
1%      2778.93    3.40   -3.13      0.18
25%     4440.10    4.90    2.27      3.51
50%     6559.59    5.70    3.24      5.01
75%     9629.35    6.80    4.97      6.66
99%    13366.02   10.10   13.56     14.57
max    13415.27   10.70   14.62     15.33
Dos cosas que este describe deja ver y el predeterminado no. La inflación
llega a −8.79 %, o sea deflación fuerte, y a +14.62 %: un rango de más
de veintitrés puntos que ninguna media de 3.96 sugiere. Y memory_usage con
deep=True es el único que cuenta de verdad las columnas de texto; sin ese
argumento, una columna object reporta ocho bytes por fila y miente por un
factor de diez.
Seleccionar: .loc incluye el extremo, .iloc no
por_etiqueta = d.loc["2008Q1":"2008Q4", ["realgdp", "unemp"]]   # 4 filas
por_posicion = d.iloc[-4:, :2]                                   # 4 filas

# Filtro booleano: la forma correcta de preguntar "¿cuándo pasó X?"
crisis = d[(d["unemp"] > 8) & (d["infl"] < 3)]
Un corte por etiqueta con .loc incluye el extremo derecho; uno posicional
con .iloc no. Es la fuente de errores por un elemento más frecuente de
pandas, y no hay manera de deducirlo: hay que saberlo. d.loc["2008Q1":"2008Q4"]
devuelve cuatro trimestres, los cuatro de 2008.
En el filtro booleano, los paréntesis alrededor de cada condición son
obligatorios. & tiene mayor precedencia que > en Python, así que sin ellos
la expresión se agrupa mal y el error que sale no se parece en nada a la causa.
La consulta de arriba devuelve cuatro trimestres con desempleo alto e inflación baja: 1982Q1, 1982Q3, 1982Q4 y 2009Q1.
Columnas derivadas, y el error de anualizar mal
x["gdp_qoq"] = x["realgdp"].pct_change() * 100
x["gdp_anualizado"] = ((1 + x["realgdp"].pct_change()) ** 4 - 1) * 100
x["gdp_yoy"] = x["realgdp"].pct_change(periods=4) * 100
x["unemp_delta"] = x["unemp"].diff()
pct_change() da la variación entre períodos consecutivos y diff() la
diferencia absoluta. La distinción entre las dos es la distinción entre "creció
2 %" y "subió 2 puntos", que en una serie de tasas no es lo mismo y se confunde
todo el tiempo.
Anualizar una variación trimestral es elevar a la cuarta, no multiplicar por cuatro. El interés compuesto no es lineal. En el peor trimestre de la muestra, 1980Q2, la caída trimestral fue de −2.05 %:
peor trimestre anualizado: 1980Q2 con -7.95 %
  (la variación trimestral simple fue -2.05 %,
   así que multiplicar por 4 habría dado -8.20 %,
   un error de 0.25 puntos)
Un cuarto de punto porcentual sobre una cifra que va a un informe. El error crece con la magnitud, así que justo en los trimestres que más importan es cuando más miente.
groupby: agg colapsa, transform no
x["decada"] = (x.index.year // 10) * 10
tabla = x.groupby("decada").agg(
    trimestres=("realgdp", "size"),
    gdp_medio=("gdp_anualizado", "mean"),
    gdp_peor=("gdp_anualizado", "min"),
    desempleo_medio=("unemp", "mean"),
    inflacion_media=("infl", "mean"),
)
La sintaxis de tupla nombrada, nombre=(columna, función), produce columnas ya
bautizadas en vez del MultiIndex que sale de agg(["mean", "min"]) y que
después hay que aplanar a mano.
        trimestres  gdp_medio  gdp_peor  desempleo_medio  inflacion_media
decada
1960            40       4.41     -5.03             4.78             2.55
1970            40       3.38     -4.78             6.22             7.22
1980            40       3.11     -7.95             7.28             4.91
1990            40       3.34     -3.46             5.76             2.83
2000            39       1.74     -6.43             5.42             2.52
La otra mitad de groupby es transform, que devuelve algo del mismo largo
que el original en vez de colapsar:
# Normalizar dentro del grupo sin perder filas
x["gdp_z_decada"] = x.groupby("decada")["gdp_anualizado"].transform(
    lambda s: (s - s.mean()) / s.std()
)
Esa distinción es la que uno busca cuando quiere preguntar "¿qué trimestres fueron atípicos respecto de su propia década?", que no es lo mismo que atípicos respecto de toda la muestra. El primero de la lista resulta ser 1990Q4, con 3.03 desviaciones bajo la media de los noventa, aunque en términos absolutos hubo trimestres peores en otras décadas.
Ventanas: tres formas de suavizar, y una que no se puede usar
v["movil_4"] = x["unemp"].rolling(4).mean()
v["movil_4_centrada"] = x["unemp"].rolling(4, center=True).mean()
v["acumulada"] = x["unemp"].expanding().mean()
v["exponencial"] = x["unemp"].ewm(span=4, adjust=False).mean()
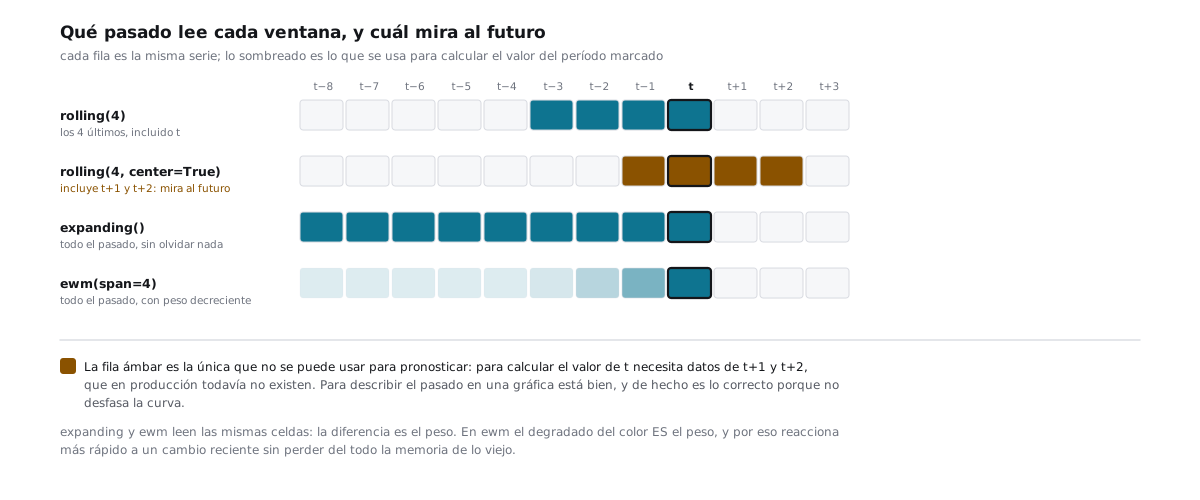
rolling toma una ventana fija; expanding acumula desde el inicio; ewm
pondera el pasado con decaimiento exponencial, así que reacciona más rápido que
la móvil simple sin perder tanta memoria.
center=True mira al futuro. Para describir el pasado en un gráfico está
bien, y de hecho es lo correcto porque no desfasa la curva. Para alimentar un
modelo de pronóstico es fuga de información: el valor de una media centrada en
el trimestre t usa datos de t+2, que en producción todavía no existen.
Un truco de diagnóstico que uso siempre:
v.notna().idxmax() # primer valor no nulo de cada columna
Dice cuánto pasado necesita cada transformación antes de producir algo. La móvil de 4 arranca en 1959Q4, la centrada en 1959Q3, la exponencial desde el primer dato.
Largo contra ancho
El formato largo es lo que sale de casi cualquier base de datos: una fila por observación, con una columna que dice qué serie es. El ancho es lo que quiere casi cualquier gráfica: una columna por serie.
largo = (
    x.loc["2007Q1":"2009Q3", ["unemp", "infl", "tbilrate"]]
    .reset_index()
    .melt(id_vars="trimestre", var_name="serie", value_name="valor")
)
ancho = largo.pivot(index="trimestre", columns="serie", values="valor")
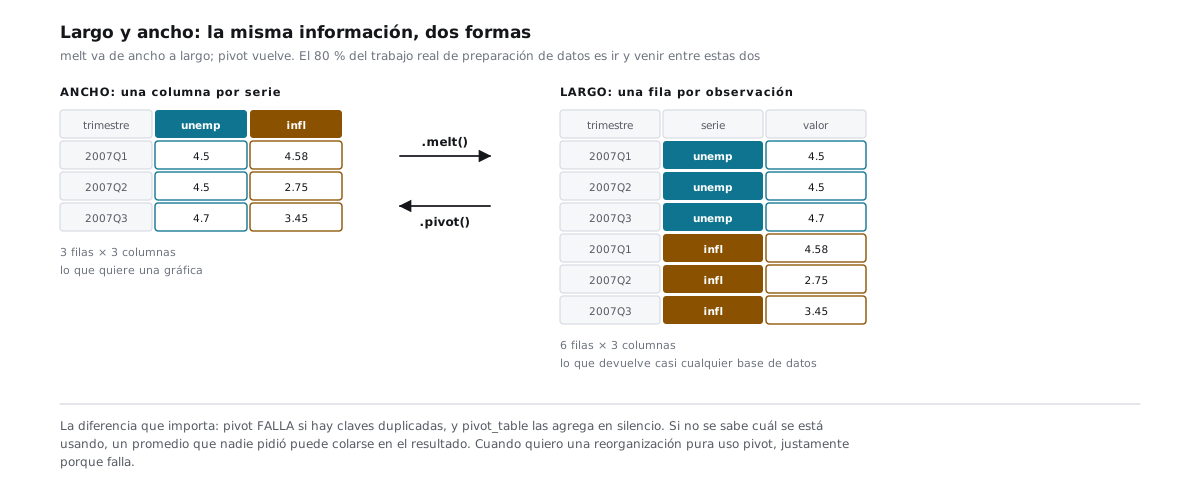
melt va de ancho a largo y pivot de vuelta. Once trimestres por tres series
dan 33 filas en largo y una tabla de 11×3 en ancho.
La diferencia que importa: pivot falla si hay duplicados; pivot_table los
agrega en silencio. Si no se sabe cuál se está usando, un promedio no
solicitado puede colarse en el resultado sin ninguna advertencia. Cuando quiero
que la operación sea una reorganización pura, uso pivot justamente porque
falla.
Unir tablas: el argumento que evita el error más caro
izq.merge(der, on="trimestre", how="left", validate="one_to_one")
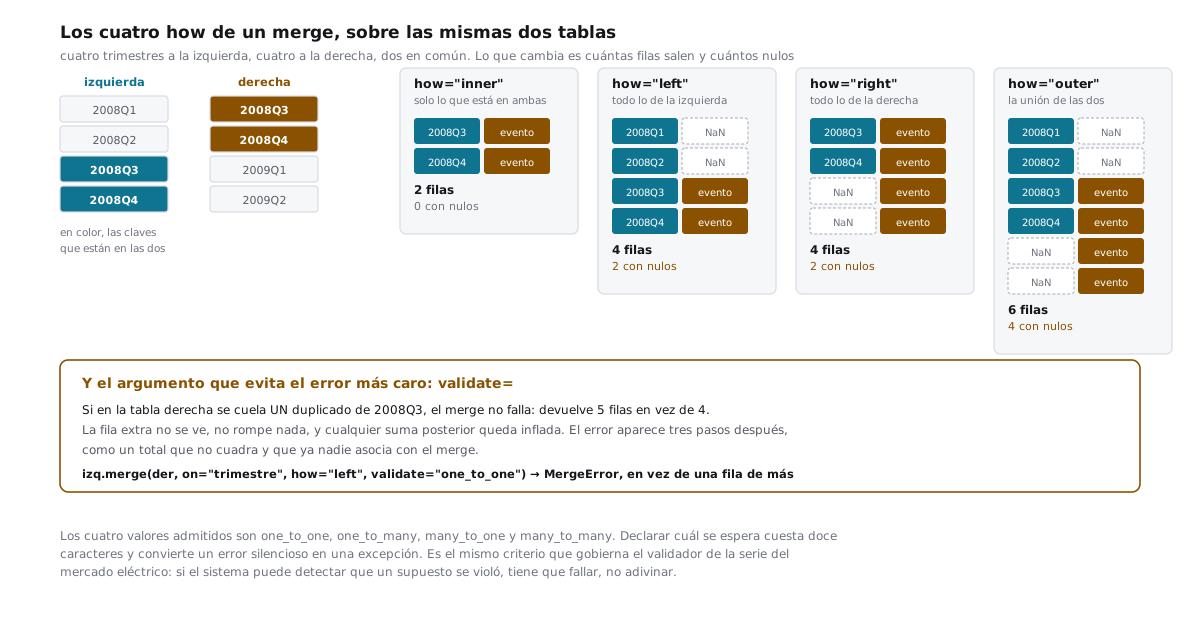
validate= es el argumento que más errores previene y que casi nadie usa. Si la
relación no es la declarada, falla en vez de duplicar filas en silencio. Con
un solo duplicado en la tabla derecha:
con un duplicado en la derecha, validate falla: MergeError
  sin validate el merge habría devuelto 5
  filas en vez de 4, inflando cualquier suma posterior
Ese es el modo de falla clásico de un merge mal hecho: no explota, devuelve
filas de más, y el error aparece tres pasos después como un total que no cuadra.
Los valores admitidos son one_to_one, one_to_many, many_to_one y
many_to_many; declarar cuál se espera cuesta doce caracteres.
Sobre how, con las mismas dos tablas de cuatro filas cada una y dos
trimestres en común:
how=inner  → 2 filas, 0 eventos nulos
how=left   → 4 filas, 2 eventos nulos
how=outer  → 6 filas, 2 eventos nulos
Faltantes: cuatro estrategias, tres de ellas mienten
tabla = pd.DataFrame({
    "original": s,
    "ffill": s.ffill(),
    "interpolar": s.interpolate(),
    "media": s.fillna(s.mean()),
})
Con dos trimestres borrados a propósito entre 4.7 y 5.4:
           original  ffill  interpolar  media
2007Q3          4.7    4.7        4.70   4.70
2007Q4          NaN    4.7        4.93   5.33
2008Q1          NaN    4.7        5.17   5.33
2008Q2          5.4    5.4        5.40   5.40
ffill arrastra el último valor conocido. Es correcto para un stock, como
el nivel de un tanque, que efectivamente sigue ahí hasta que alguien lo cambie.
Es falso para un flujo, como energía generada en un intervalo: si no hay
lectura, no significa que se haya generado lo mismo que antes.
interpolate() supone linealidad entre los extremos conocidos, que es
razonable para una magnitud física continua y arbitrario para una serie con
saltos.
fillna(media) es la más usada y la más peligrosa: destruye la varianza.
Cada valor imputado cae exactamente en la media, así que cualquier desviación
estándar, intervalo de confianza o prueba estadística calculada después sale
sesgada hacia la falsa precisión. Y no deja rastro.
La regla que sigo: imputar es una decisión de modelado, no de limpieza, y tiene
que quedar registrada. Si no se puede justificar por qué el hueco se rellenó
así, lo correcto es dejarlo en NaN y que las funciones río abajo lo propaguen.
Las cuatro bibliotecas de gráficos
Resuelven el mismo problema con contratos distintos. El script graficas.py
hace deliberadamente la misma figura con las cuatro, para que la comparación sea
sobre la herramienta y no sobre el ejemplo.
Antes de nada, una línea que ahorra horas:
import matplotlib
matplotlib.use("Agg")           # ANTES de importar pyplot, no después
import matplotlib.pyplot as plt
El backend Agg no abre ventanas: escribe archivos. Es lo que hay que usar en
un script, en integración continua o en un servidor. Sin eso, el mismo código
puede bloquearse esperando una ventana que nunca se va a abrir.
pandas: una línea, para mirar algo ahora
ax = d.set_index("fecha")[["unemp", "infl"]].plot(
    figsize=(10, 4), title="Desempleo e inflación, 1959 a 2009"
)
El método .plot de un DataFrame es matplotlib por debajo, con los ejes ya
puestos. Para mirar una serie mientras se explora, es imbatible. Para publicar,
no: el control fino termina siendo más trabajo que haber empezado con
matplotlib.
matplotlib: control total, salida reproducible
fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(d["fecha"], d["unemp"], color="#0e7490", lw=1.8, label="desempleo")
ax.plot(d["fecha"], d["infl"], color="#8a5200", lw=1.4, label="inflación")

# Sombrear las recesiones que el propio dato muestra:
# dos trimestres seguidos de caída del PIB real.
caida = d["realgdp"].pct_change() < 0
recesion = caida & caida.shift(1)
for f in d.loc[recesion, "fecha"]:
    ax.axvspan(f - pd.Timedelta(days=91), f, color="#14161a", alpha=0.07, lw=0)

ax.legend(frameon=False, loc="upper right")
ax.spines[["top", "right"]].set_visible(False)
fig.savefig("2-matplotlib.png", dpi=110, bbox_inches="tight")
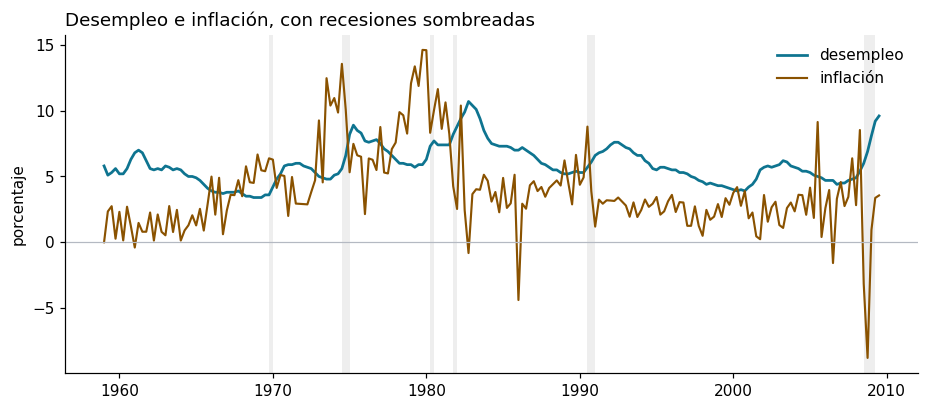
Más código, y a cambio nada que la biblioteca decida por su cuenta. Para una figura que va a un informe eso es justamente lo que se quiere: que el resultado no cambie porque cambió una versión.
bbox_inches="tight" recorta el margen sobrante, que es la diferencia entre una
figura que se ve bien en un documento y una con un marco blanco enorme.
seaborn: hace la estadística, no solo el dibujo
sns.set_theme(style="whitegrid", font_scale=0.9)
fig, axes = plt.subplots(1, 2, figsize=(11, 4))

sns.boxplot(data=d, x="decada", y="unemp", ax=axes[0],
            color="#0e7490", fill=False, linewidth=1.3)

sns.regplot(data=d, x="unemp", y="infl", ax=axes[1],
            scatter_kws={"s": 14, "alpha": 0.55},
            line_kws={"color": "#8a5200", "lw": 2})
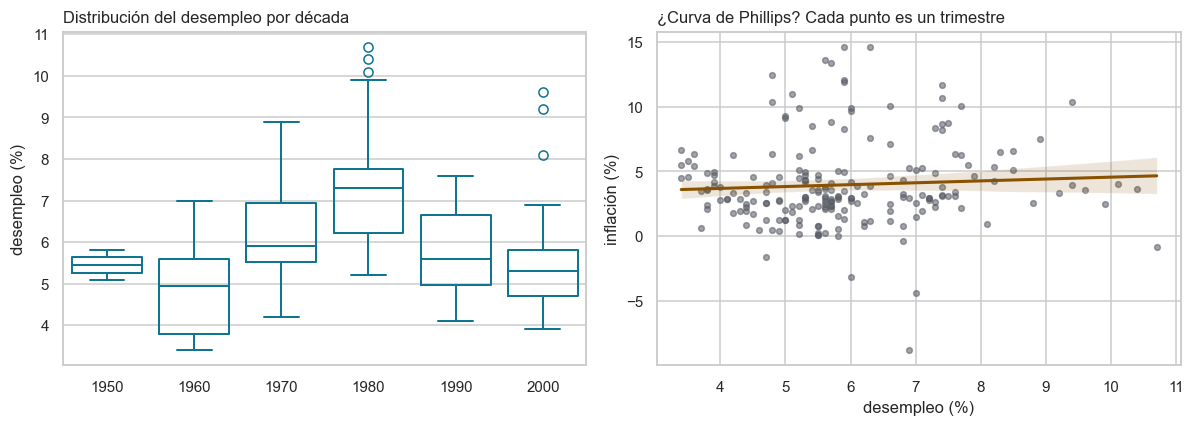
Esa es la diferencia práctica: en matplotlib uno dibuja lo que ya calculó; en seaborn le pasa los datos crudos y la biblioteca decide qué calcular. Cuando la agregación que hace es la que uno quería, ahorra mucho. Cuando no lo es, y no se revisó, publica una estadística que nadie pidió.
plotly: interactivo, sale a HTML
import plotly.express as px

fig = px.scatter(
    d, x="unemp", y="infl", color="decada", hover_name=d.index.astype(str),
    title="Desempleo contra inflación, coloreado por década",
)
fig.update_layout(template="simple_white", height=460)
fig.write_html("4-plotly.html", include_plotlyjs="cdn")
include_plotlyjs="cdn" deja el archivo en 16.8 KiB; con True queda
autocontenido y pesa varios megabytes. Es una decisión que hay que tomar a
conciencia según dónde va a vivir el archivo: la primera opción exige internet
para verlo, la segunda funciona en un pendrive.
Plotly gana cuando el lector tiene que explorar: pasar el mouse para saber qué trimestre es cada punto, hacer zoom, apagar series. Pierde cuando la figura va a un PDF, a un informe impreso o a cualquier lado donde no haya un navegador.
Cómo elijo
| Situación | Herramienta |
|---|---|
| Mirar una serie mientras exploro | .plot de pandas |
| Figura para un informe o un PDF | matplotlib |
| Distribuciones, comparación entre grupos, regresión con banda | seaborn |
| El lector tiene que explorar los puntos | plotly |
| Integración continua, servidor sin pantalla | matplotlib con Agg |
Fuentes
Este artículo es un laboratorio, no una investigación documental. Lo que afirma
se verifica corriendo el código, y las cifras que cita son la salida real de
lab.py y graficas.py.
- Código completo:
proyectos/lab-pandas.lab.py(ocho secciones de pandas) ygraficas.py(las cuatro bibliotecas).salida.txtes la corrida que este artículo cita. - Datos:
statsmodels.datasets.macrodata, empaquetado con la biblioteca. 203 observaciones trimestrales, 1959Q1 a 2009Q3, de cuentas nacionales de Estados Unidos. La descripción de cada variable la leí desm.datasets.macrodata.NOTE, que es la fuente que acompaña al dataset, no mi memoria. - Versiones con las que corrió: Python 3.13.9, pandas 2.3.3, numpy 2.3.5,
statsmodels 0.14.5, matplotlib 3.10.6, seaborn 0.13.2, plotly 6.3.0. Las
cifras corresponden a esas versiones, y el comportamiento de
PeriodIndex.from_fieldsen particular cambió en pandas 2.2. - Documentación oficial, para lo que este artículo solo roza: pandas, matplotlib, seaborn y plotly. No las abrí para escribir esto y no las cito como respaldo de ninguna afirmación concreta: cada afirmación de este artículo sale de correr el código. Van como punto de partida para el lector, no como fuente.
El artículo siguiente toma el resultado incómodo de la figura de seaborn, la recta de Phillips con la pendiente equivocada, y lo usa para ordenar los fundamentos de estadística que un analista necesita.