Mercado eléctrico mayorista de El Salvador 8 de 8
Mercado mayorista VIII. Pronóstico de demanda, comparación honesta de tres enfoques
La programación semanal necesita, entre sus insumos, una proyección de demanda: energía semanal y demanda de potencia horaria por barra (ROBCP 9.3.1 a). Este artículo compara tres maneras de producir la primera de esas dos cosas y reporta lo que salió, incluido lo que salió mal.
"Comparación honesta" significa acá cinco cosas concretas, y conviene fijarlas antes de mirar un solo número, porque son el criterio con el que hay que juzgar cualquier informe de pronóstico ajeno: reportar la línea base, evaluar de la única manera que reproduce la situación real, publicar las métricas desagregadas en vez del promedio que favorece, evaluar también los intervalos, y declarar en qué el ejercicio está sesgado a favor de uno de los modelos. Los cinco aparecen abajo, y el último es el más incómodo.
El código está en
proyectos/pronostico-demanda.
La serie es sintética, la evaluación no
La serie de demanda real de El Salvador no es pública, y hay tres salidas posibles ante eso: inventar números y presentarlos como resultados, no publicar números, o generar una serie sintética con la estructura de una demanda real y correr sobre ella un experimento de verdad. Este artículo toma la tercera.
La serie tiene cuatro años de energía diaria con tendencia, estacionalidad anual y semanal (con sábado distinto de domingo), feriados de fecha fija con caída fuerte, una serie exógena de temperatura con su propio ciclo, y ruido autocorrelacionado AR(1) porque el error de un día se parece al del anterior.
Lo que es real es todo lo demás. Los modelos se ajustan de verdad, el backtesting corre de verdad, las métricas son las que salieron de la corrida, y lo que falló quedó escrito en vez de corregirse en silencio.
Por qué origen móvil
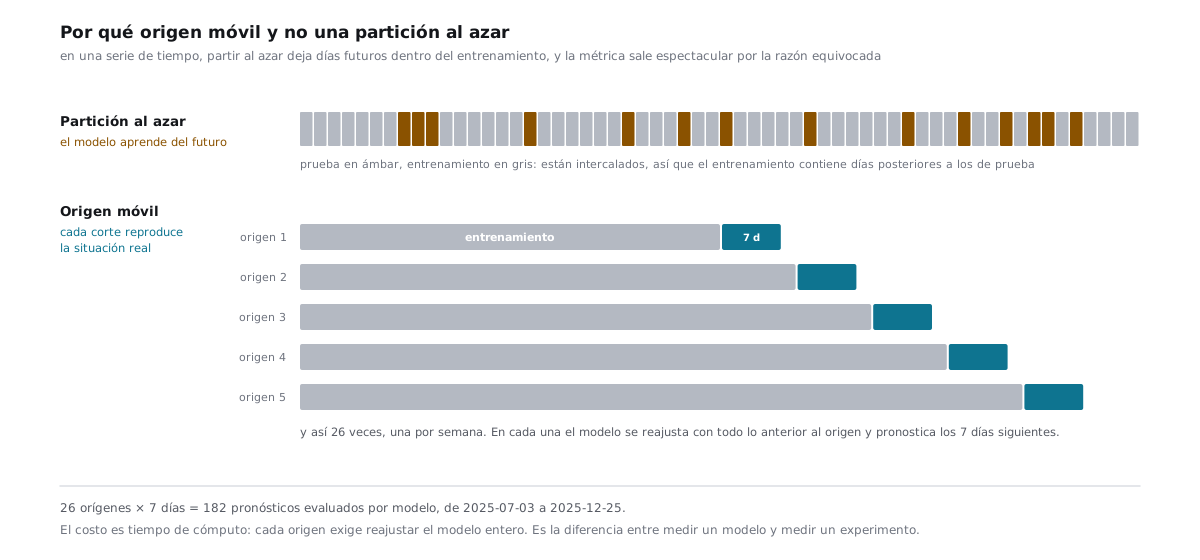
Veintiséis orígenes, uno por semana, medio año de prueba. En cada origen los tres modelos se reajustan con todo lo anterior y pronostican los siete días siguientes, que es exactamente el horizonte de la programación semanal. Son 182 pronósticos evaluados por modelo.
Una advertencia que hay que hacer y casi nadie hace: las exógenas del futuro se toman como conocidas. En operación no lo son. La temperatura de dentro de siete días viene de un pronóstico meteorológico que tiene su propio error, y ese error se suma al del modelo de demanda. Los números de abajo son optimistas por esa razón, y hay que saberlo antes de compararlos con el error de un sistema en producción.
Los tres modelos
Línea base estacional. El valor del mismo día de la semana anterior. Una línea de código. Es la que casi nadie reporta, y es contra la que hay que ganar antes de hablar de cualquier otra cosa: un modelo que no le gana a esto no justifica su existencia, sin importar cuán sofisticado sea.
SARIMAX(1,1,1)(1,1,1,7) con dos exógenas, grados de refrigeración sobre una base de confort y una bandera de feriado. Se ajusta sobre los últimos dos años, que bastan para la estacionalidad semanal y mantienen el tiempo en segundos.
Gradient boosting, con estrategia directa: un modelo por horizonte, siete en
total, más dos modelos cuantílicos por horizonte para P10 y P90. Los rasgos son
calendario, clima y estructura de la propia serie: rezagos de 1, 2, 3, 7, 14, 28
y 364 días, medias móviles de 7 y 28 y desviación de 7. Usa
HistGradientBoostingRegressor de scikit-learn en vez de LightGBM para que el
proyecto corra sin instalar nada.
El error que casi se publica como hallazgo
La primera corrida dio esto: el boosting con un MAE de 1012 MWh por día, contra 754 de la línea base. Un 34 % peor que copiar la semana anterior.
Acá es donde se cuela el error más común de un informe de modelado. Existe un párrafo cómodo, verdadero en general, que habría encajado perfecto: "en series de longitud moderada los modelos simples suelen superar a los complejos". Escribirlo habría cerrado el asunto con una explicación elegante y equivocada.
Un modelo con rezagos, clima y calendario perdiendo contra la línea base no es un hallazgo, es un síntoma. El defecto estaba en la construcción de los rasgos: se armaban indexados por el origen y se desplazaba el objetivo hacia adelante, de modo que el modelo del horizonte 7 se entrenaba viendo el calendario y la temperatura del origen, pero al predecir recibía el calendario y la temperatura del día objetivo. Entrenaba con una relación y predecía con otra.
La corrección fue indexar las filas por el día objetivo y desplazar hacia atrás los rezagos, de forma que ninguno mire más allá del origen:
def _rasgos(df, objetivo, h):
    """Rasgos para predecir el día d con la información disponible en d - h."""
    x = pd.DataFrame(index=df.index)
    x["dow"] = df.index.dayofweek        # del día objetivo: el almanaque se conoce
    x["cdd"] = df["cdd"].to_numpy()      # del día objetivo: viene del pronóstico
    for r in REZAGOS:
        x[f"lag{r}"] = objetivo.shift(h + r - 1)   # nunca más allá del origen
    base = objetivo.shift(h)
    x["media7"] = base.rolling(7).mean()
    return x
Con eso el boosting pasó de 1012 a 429, es decir de un 34 % peor a un 43 % mejor que la línea base. Nada más cambió: ni un hiperparámetro, ni un rasgo.
Esa es la lección más útil del ejercicio, y vale más que cualquiera de las métricas de abajo. Un desalineamiento entre entrenamiento y predicción no aparece en ninguna métrica de entrenamiento: el modelo ajusta bien lo que le enseñaron, solo que le enseñaron otra cosa. Lo único que lo delata es una comparación contra una línea base tonta. Sin la línea base en el informe, el resultado publicado habría sido un modelo roto con una explicación creíble.
Los resultados
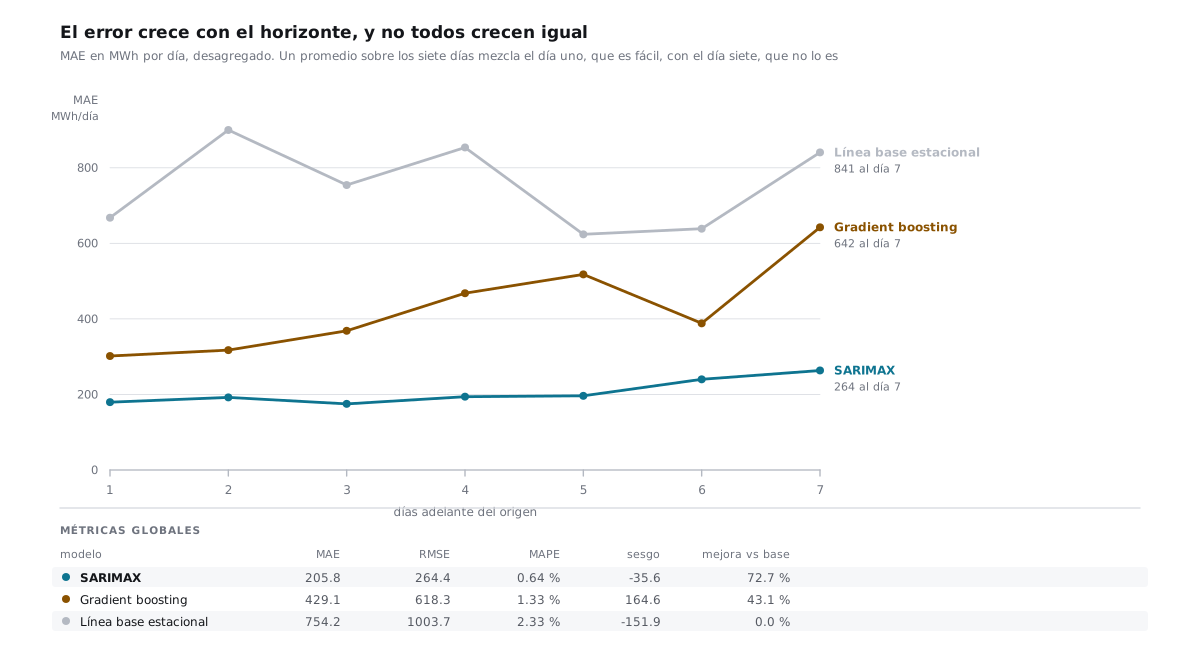
El SARIMAX gana con claridad: 205.8 MWh de MAE contra 429.1 del boosting y 754.2 de la línea base. Su degradación con el horizonte es notablemente suave, de 180 en el día uno a 264 en el día siete, mientras el boosting pasa de 302 a 642.
La forma de las curvas es lo interesante. La línea base oscila alto y sin tendencia, y no se degrada con el horizonte porque no tiene nada que degradar: predice lo mismo con un día que con siete. El boosting arranca bien pero pierde precisión rápido, de 302 a 642, porque sus rezagos se alejan: para el horizonte 7 el dato más fresco que ve tiene una semana. El SARIMAX modela la estructura de la serie en vez de memorizar sus valores recientes, y por eso el horizonte lo castiga menos: gana en los siete horizontes, incluido el primero, y su curva es casi plana.
También vale mirar el sesgo, que la tabla reporta y casi ningún informe incluye. La línea base tiene sesgo negativo (−152), el boosting positivo (+165) y el SARIMAX pequeño (−36). Un modelo con sesgo sistemático es corregible con una constante; uno sin sesgo pero con mucha varianza, no.
Por qué este resultado no se puede extrapolar
Acá está la parte que hace que esto sea una comparación honesta y no una demostración.
El SARIMAX gana en parte porque la serie está hecha a su medida. La serie se generó con una tendencia lineal, estacionalidades sinusoidales, efectos aditivos de calendario y ruido AR(1). Eso es, casi literalmente, la clase de proceso que un SARIMAX asume. El experimento le pidió a un modelo que recuperara la misma estructura con la que se construyeron los datos, y conviene desconfiar de cualquier comparación que no declare este punto.
Una demanda real no es así. Tiene quiebres estructurales, respuesta no lineal a la temperatura, efectos de calendario que interactúan entre sí, y en un sistema con generación distribuida creciente tiene además una demanda neta que cambia de forma. En ese terreno el boosting tiene ventajas que acá no se ven, porque acá no hay ninguna no linealidad interesante que capturar.
Así que la conclusión defendible no es "el SARIMAX es mejor". Es esto: en una serie con estructura lineal fuerte y cuatro años de historia, un modelo estadístico bien especificado gana, corre en una fracción del tiempo (67 segundos contra 415 del boosting, según la propia corrida) y es interpretable. Cuál gana en la serie real es una pregunta empírica que se responde repitiendo este mismo backtesting sobre esa serie, y este proyecto es la maquinaria para hacerlo, no la respuesta.
Los intervalos, que es donde de verdad falló
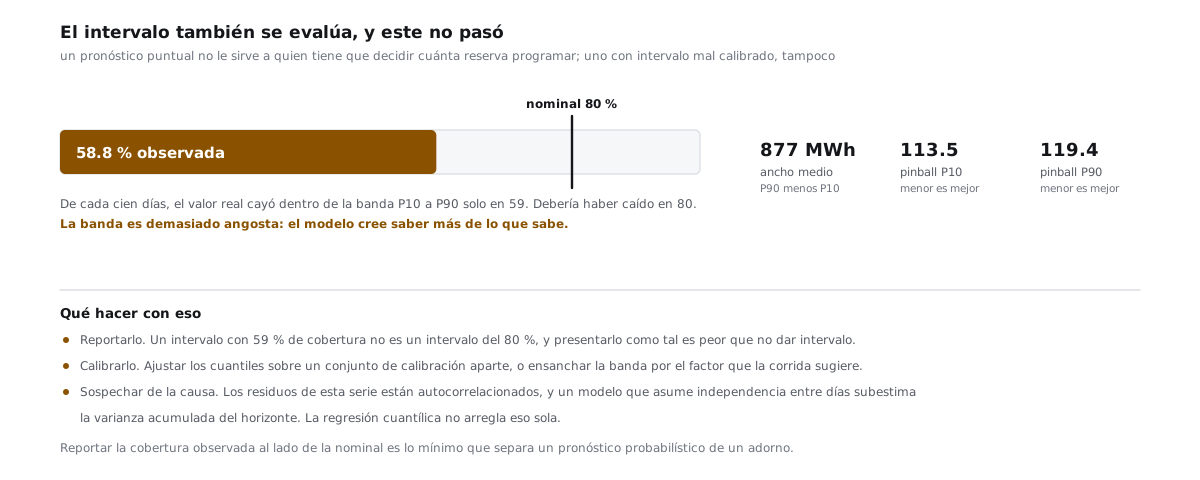
Los modelos cuantílicos del boosting producen una banda P10 a P90 que debería contener el valor real el 80 % de las veces. Contiene el 58.8 %.
La causa más probable la puse en la figura y la repito porque es general: el ruido de esta serie está autocorrelacionado, y un modelo que trata cada día como independiente subestima la varianza acumulada del horizonte. La regresión cuantílica aprende la dispersión condicional que ve en los datos de entrenamiento, no la dispersión de un error que se acumula a lo largo de siete días. Ensanchar la banda arbitrariamente hasta que la cobertura cuadre sería hacer trampa; calibrarla sobre un conjunto de datos aparte sería lo correcto, y este proyecto no lo hace.
Queda reportado sin arreglar por dos razones. La calibración no cabe en el alcance de este artículo, y un intervalo mal calibrado y declarado como tal es más útil que uno mal calibrado y presentado como bueno.
Cómo se defiende una elección de modelo
Los números de arriba no eligen solos. Esta es la recomendación que se sostiene con ellos, con el argumento que la acompaña, que es la parte que un panel pregunta.
En producción, el SARIMAX, por tres razones que valen fuera de este experimento. Es el que menos se degrada con el horizonte, que es exactamente lo que la programación semanal necesita. Corre en una fracción del tiempo, lo que importa cuando hay que reajustar seguido. Y es interpretable, o sea que ante una desviación grande se puede explicar de dónde vino. En una entidad que tiene que justificar sus decisiones ante participantes del mercado, la interpretabilidad no es un lujo estético: es la diferencia entre poder responder una objeción y tener que decir que el modelo lo dijo.
El boosting en paralelo, sin producción, por dos motivos. En la serie real puede ganar, y la única forma de saberlo es medirlo. Y su patrón de error es distinto al del SARIMAX, y dos modelos que se equivocan de maneras distintas se pueden combinar; dos que se equivocan igual, no.
La línea base para siempre, en el informe, como control. El día que el modelo bueno se degrade por un cambio en la serie, la comparación contra la línea base es lo que lo va a delatar. En este mismo ejercicio delató un error de código antes de que llegara a publicarse.
Sobre las redes recurrentes, que es la pregunta que siempre aparece: tendrían sentido con series largas, muchas series relacionadas y alta frecuencia. Acá hay 1461 observaciones y una sola serie. Un LSTM sobre esto es una respuesta cara a una pregunta que ya contestó un modelo de veinte líneas.
Lo que le falta
Está evaluado a nivel de energía diaria, no de demanda de potencia horaria por barra, que es la otra mitad de lo que pide el numeral 9.3.1. No hay reconciliación entre horizontes: nada garantiza que la suma de los siete días coincida con la energía semanal que produciría un modelo semanal. Los intervalos no están calibrados. Y las exógenas se asumen conocidas.
Fuentes
- Código completo:
proyectos/pronostico-demanda.serie.pygenera la serie sintética con semilla fija,modelos.pylos tres enfoques con interfaz común,backtest.pyla validación con origen móvil y las métricas.resultados.jsones la corrida que alimenta las figuras de este artículo. Requiere numpy, pandas, statsmodels y scikit-learn. - Reglamento de Operación del Sistema de Transmisión y del Mercado Mayorista
Basado en Costos de Producción (ROBCP), versión actualizada a junio de 2026.
Unidad de Transacciones. Numeral 9.3.1 literal a: la proyección de demanda como
insumo de la programación semanal, en energía semanal y demanda de potencia
horaria por barra. Copia local:
normativa/robcp.pdf. Consultado el 22 de agosto de 2026. - Datos: sintéticos, generados por
serie.py. Ninguna cifra corresponde a la demanda real de El Salvador ni de ningún otro sistema. Lo que se copia de la realidad es la estructura de la serie, y el artículo explica en qué esa elección sesga la comparación.
Con este artículo cierra la serie. El registro completo de documentos primarios, con su estado de verificación, está en Fuentes primarias.